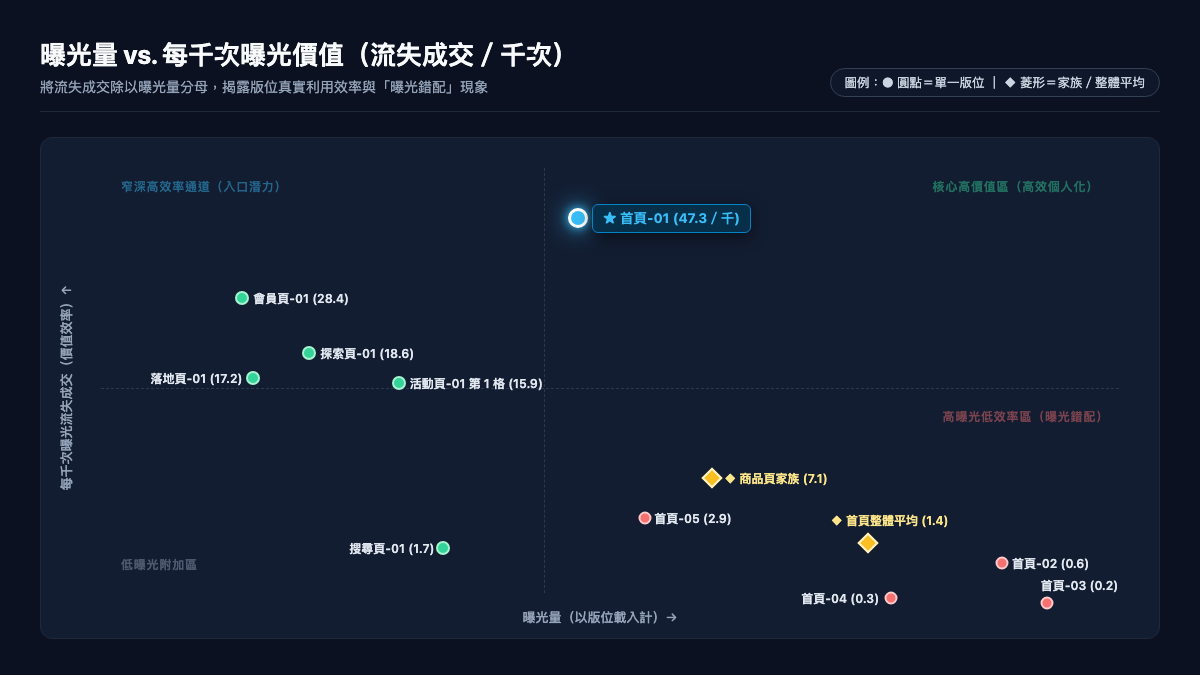
置頂App 版位價值歸因 · Markov 移除效應與實驗設計
以一階馬可夫鏈與移除效應量化 480 個版位對成交的不可替代性,揭露首頁首頁-01 39 倍於中位數的曝光錯配,並轉化為 A/B 因果實驗矩陣。
以一階馬可夫鏈與移除效應量化 480 個版位對成交的不可替代性,揭露首頁首頁-01 39 倍於中位數的曝光錯配,並轉化為 A/B 因果實驗矩陣。
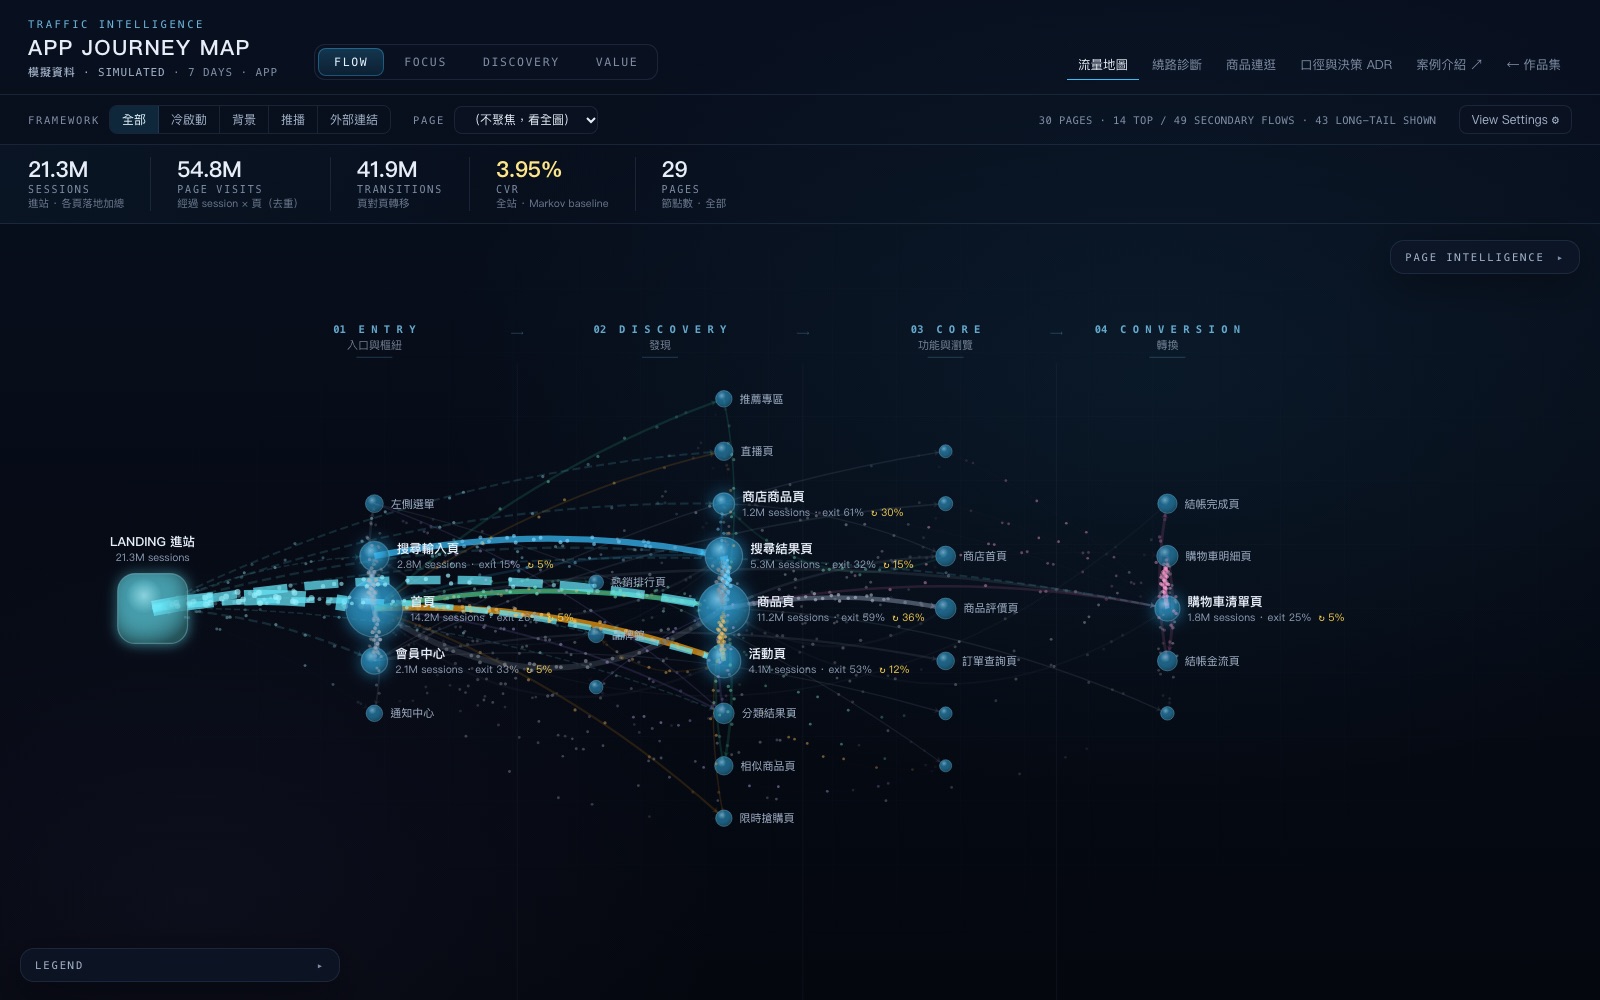
把 App 內「從哪來、靠什麼動作、往哪去」畫成一張可點選的地圖,讓團隊自己找到斷點。
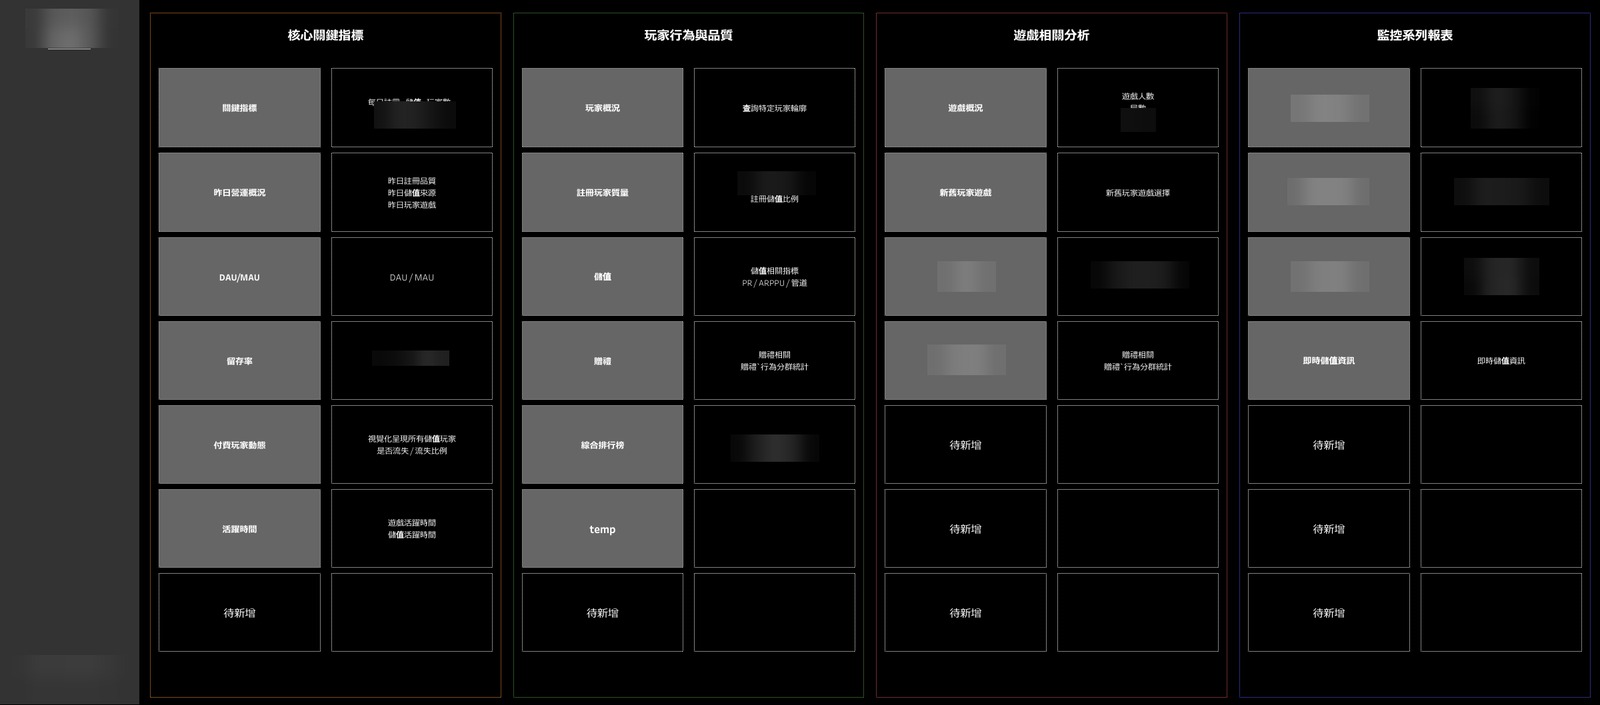
獨立負責數據平台的架構與儀表板建置,涵蓋玩家留存、活躍時段、內容偏好與儲值付費分析,並串接 Slack 自動化異常監控。
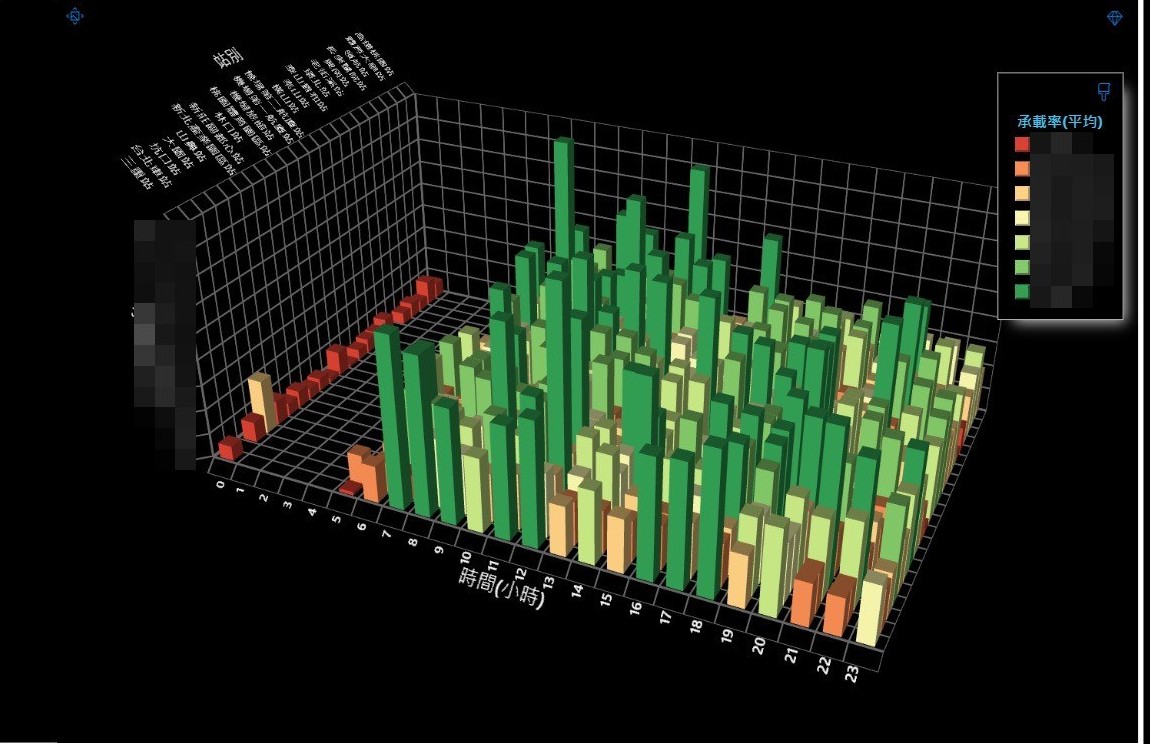
獨力完成六大類、四十多頁的運量監控報表:從站、列車到車廂三個層級,用燈號讓值班人員一眼看出哪裡擁擠。畫面中的數字為模擬資料。
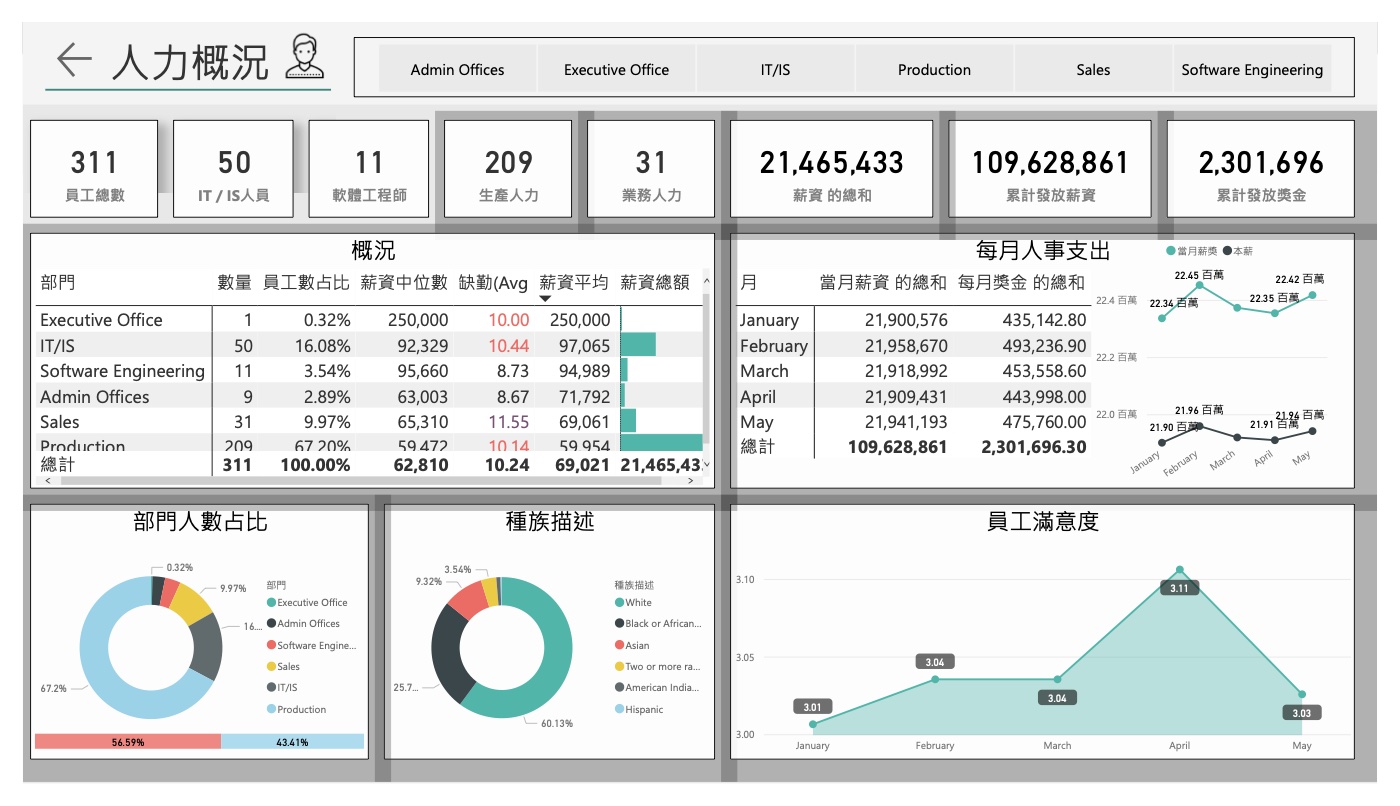
為數據分析人員與企劃同仁設計的實作課:從選對圖表,到做出一份有人會打開的儀表板。
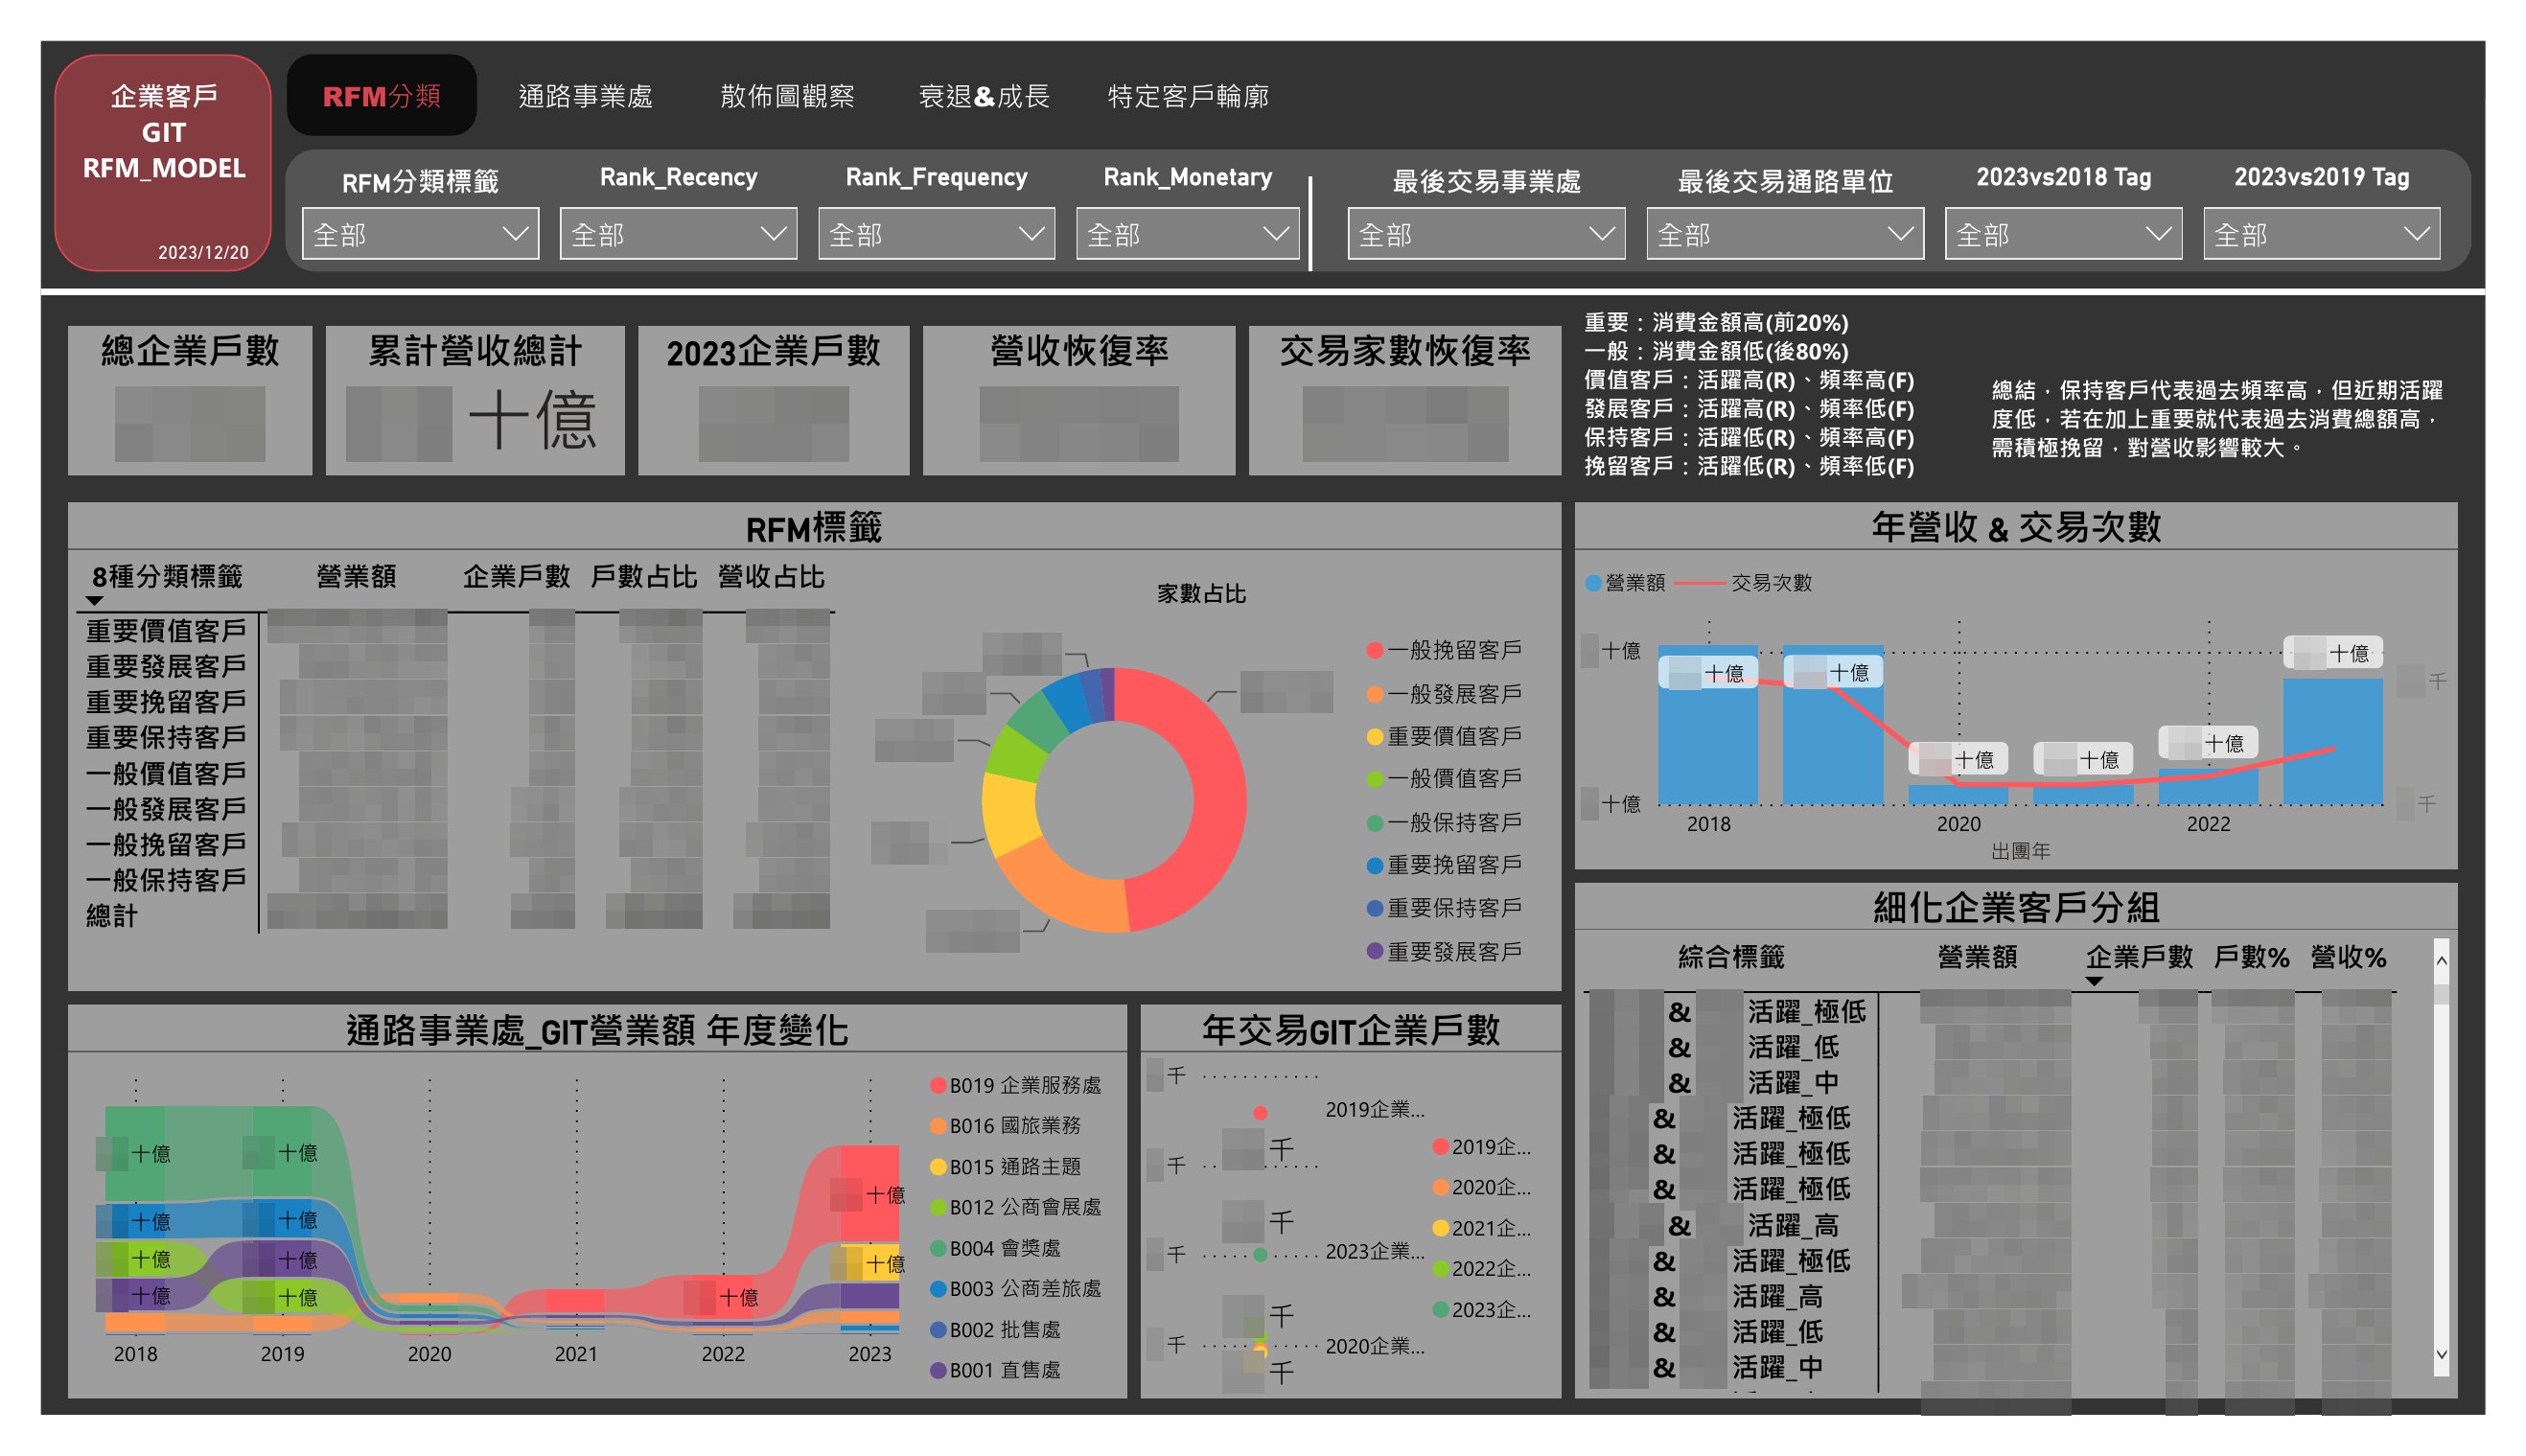
為行銷、通路主管與企業客戶業務各做一份儀表板:每日進單、月會目標達成,以及企業客戶的 RFM 分群。
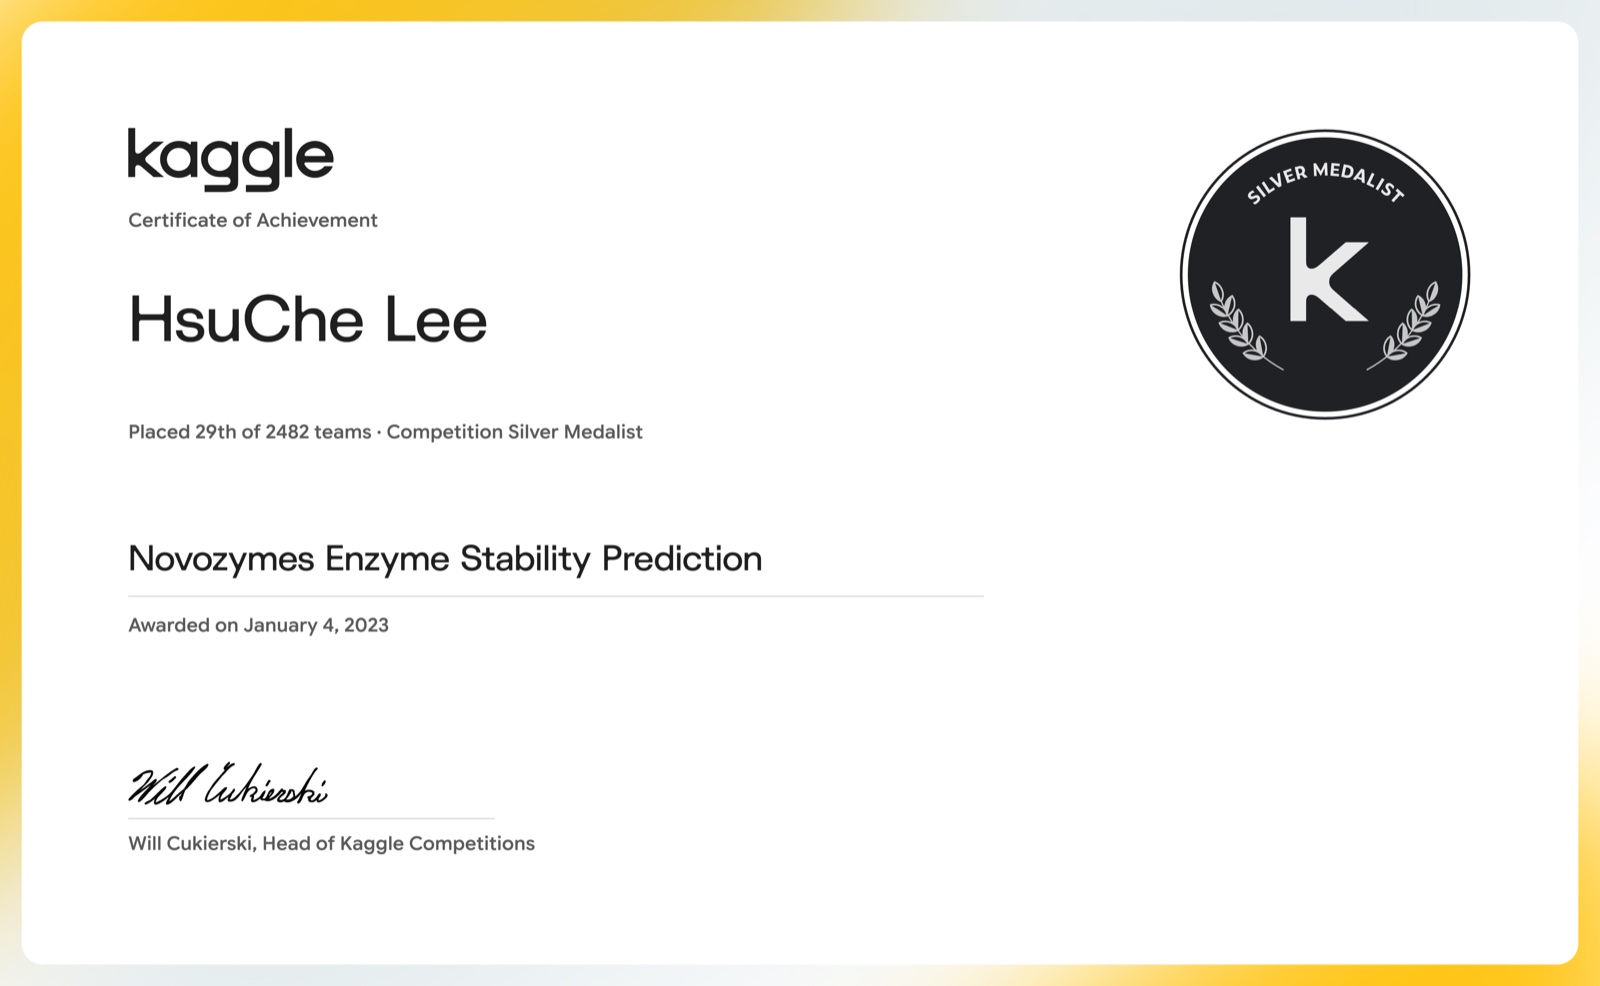
在全球 2,482 隊中名列第 29 名榮獲銀牌;融合特徵工程、生物物理模擬、蛋白質語言模型與 3D-CNN 四模型加權集成。
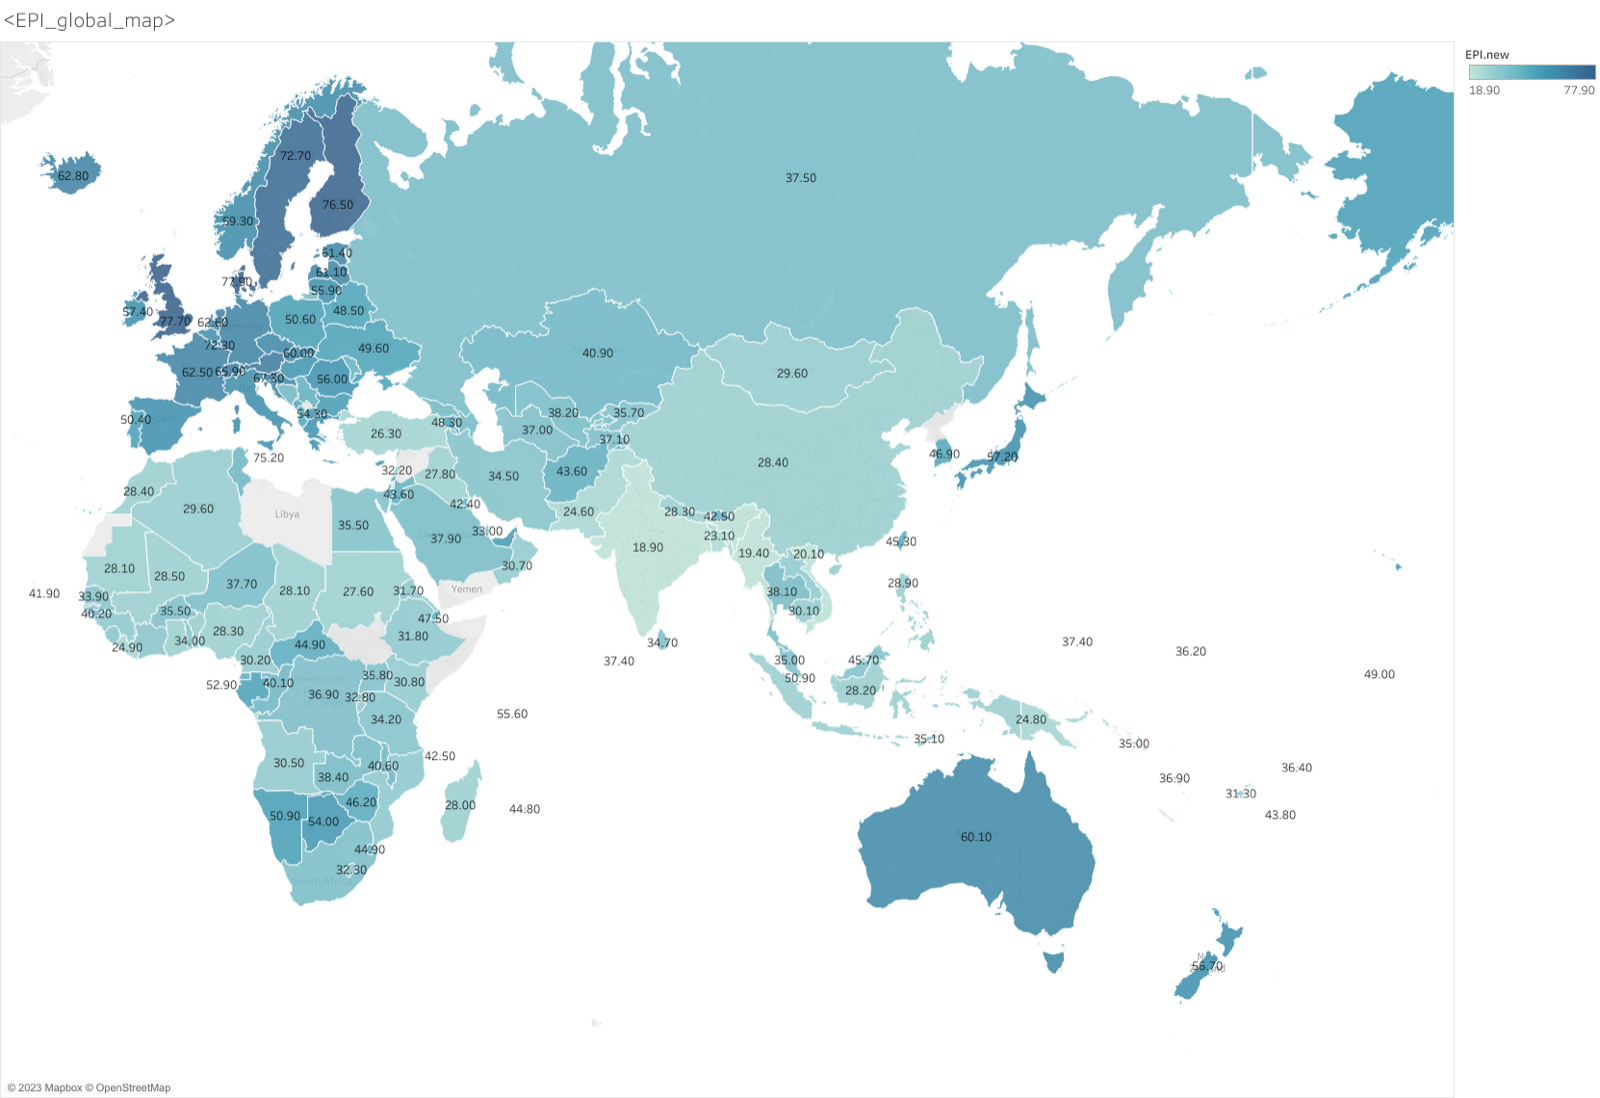
整理 2022 至 2023 年間以 Python 進行的數據分析與機器學習練習:以 Uniqlo 門市營運分析為首,涵蓋 Kaggle 競賽、房價預測、類神經網絡與環境指標評比。
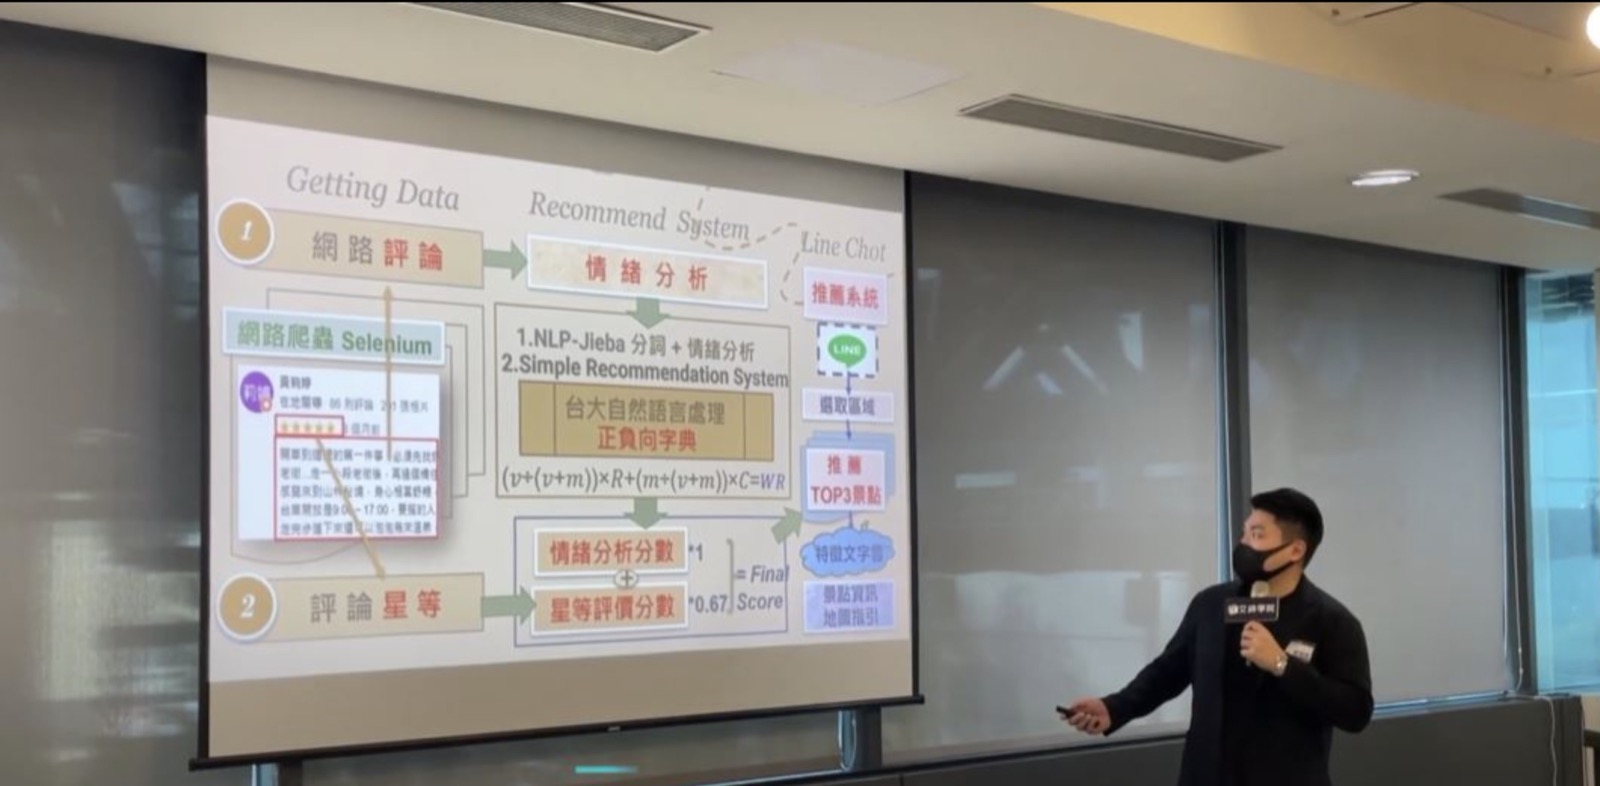
爬取 Google Maps 最新評論,以 Jieba 斷詞、正負向情緒字典與星等加權評分排序景點,做成會回傳評論文字雲的 LINE 旅遊推薦機器人。
好的 A/B Test,從來不只是在看 p-value。可靠的實驗是一條完整鏈路:把正確的問題,以可驗證的設計、足夠的資料與清楚的決策規則串起來。
數據分析的價值,不在於產出多少張圖表,而在於能否把模糊的業務疑問轉化成可驗證的問題,找出可能原因,並提出能被執行與檢驗的行動。
分析的起點不是「我有一份資料」,而是「我需要做出什麼判斷」。問題定義越精準,後續分析越不容易失焦。
資料不是越多越好,而是要能回答問題。定量資料告訴我們「發生多少、何時發生」;定性資料協助理解「為什麼發生」。
歸因的目標是評估哪些因素可能造成觀察到的結果。分析時應先描述現象,再逐步排除其他解釋,不要一開始就把相關性當成因果關係。
洞察不是把圖表上的數字換句話說,而是提出一個有證據支持、能改變決策的解釋。
七種方法不是互斥選項。實務上常常先用對比發現異常,再用趨勢確認持續性,以維度拆解定位來源,最後用漏斗、因子與分群分析深入解釋。
依照時間順序觀察指標變化,辨識長期方向、短期波動、週期性與可能的結構性轉折。
分布分析關注資料整體如何散布,而不只看一個平均數。它能回答「大多數人落在哪裡」、「差異有多大」以及「是否有極端值或長尾」。
把整體指標依不同分類切開,找出各群體的規模、表現與貢獻。它的核心問題是:「整體數字是由誰、在哪裡、透過什麼方式形成的?」
漏斗分析將使用者完成目標的過程拆成連續步驟,觀察每一步有多少人前進、多少人流失。適合分析購買、註冊、申請、預約等流程。
把一個結果指標拆成可理解的組成因子,藉此判斷結果變化是由哪個環節帶動。因子拆解能建立業務指標與可執行槓桿之間的連結。
分群分析將具有相似特徵或行為的對象分成群組,讓團隊不必用同一套策略對待所有人。分群可以依業務規則建立,也可以使用統計或機器學習方法探索。
以下用一個虛構電商案例示範,如何把五階段流程與七種分析方法串在一起。所有數字皆為教學示意。
報告中應明確標示目前結論屬於哪個層級,不要把「可能原因」寫成「已證明原因」。
情境:「最近新客變少,可能是廣告效果不好。」請將這句話改寫成包含客群定義、觀察期間、指標、比較基準與可證偽條件的分析問題。