01 · Slides
投影片展示(Presentation Decks)
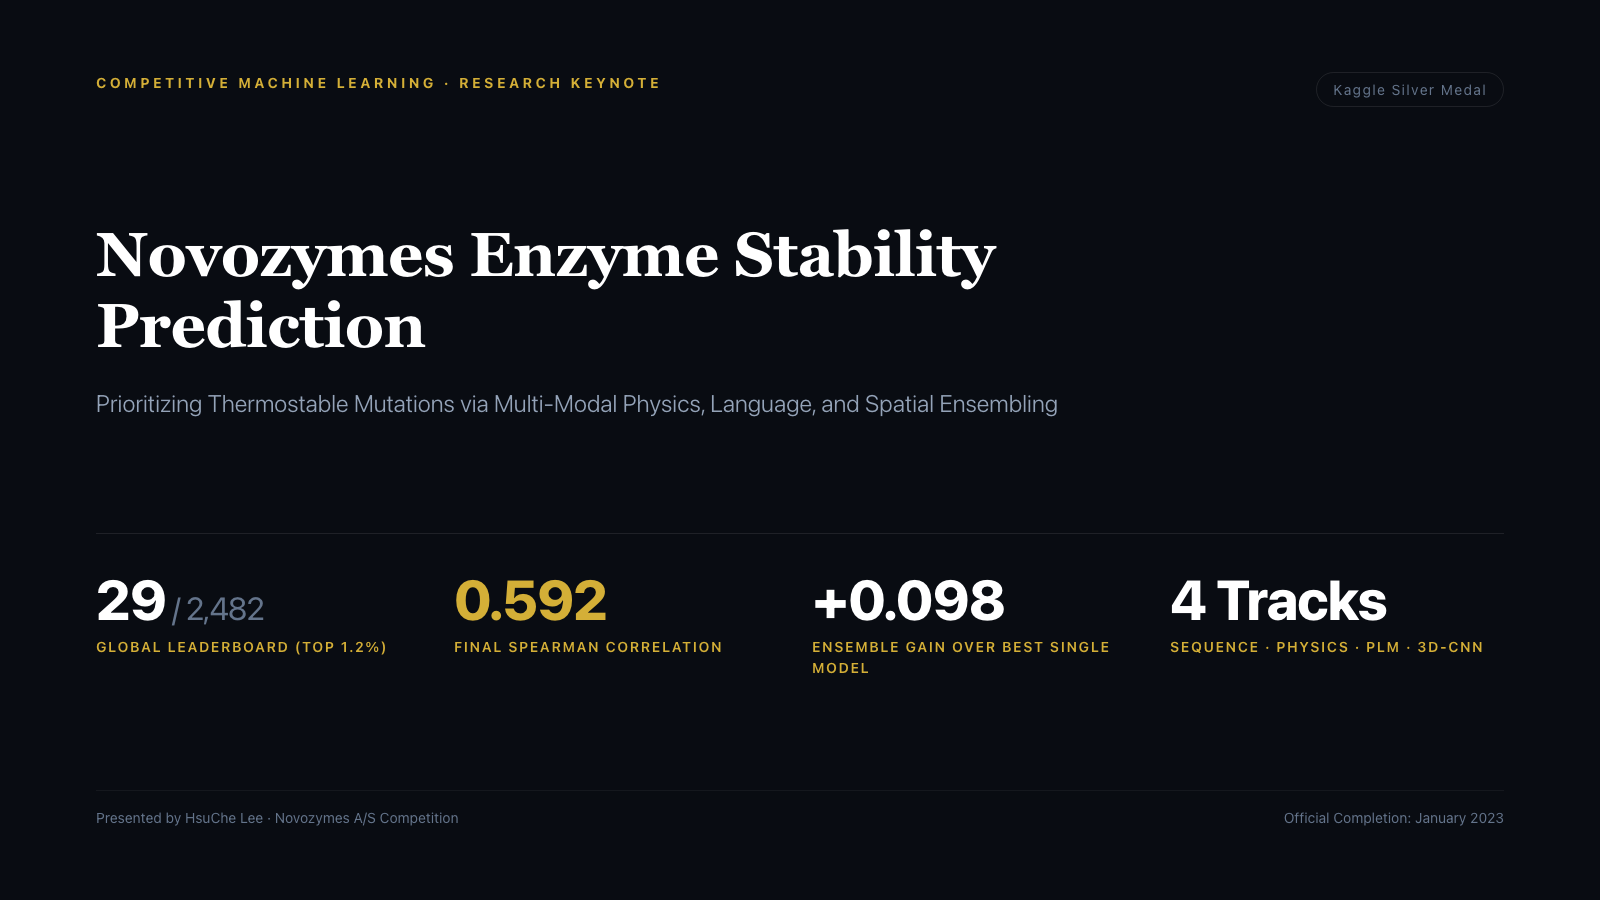
Keynote presentation deck (11 slides) highlighting the multi-track enzyme stability prediction pipeline and Kaggle 29th silver medal outcome. Click any slide to expand in full resolution:
以下收錄個人全新重構設計之投影片(共 15 頁)高清圖檔,版面、配色與圖表全部重新繪製,點擊圖片可開啟原尺寸放大檢視:
02 · Overview
比賽在比什麼
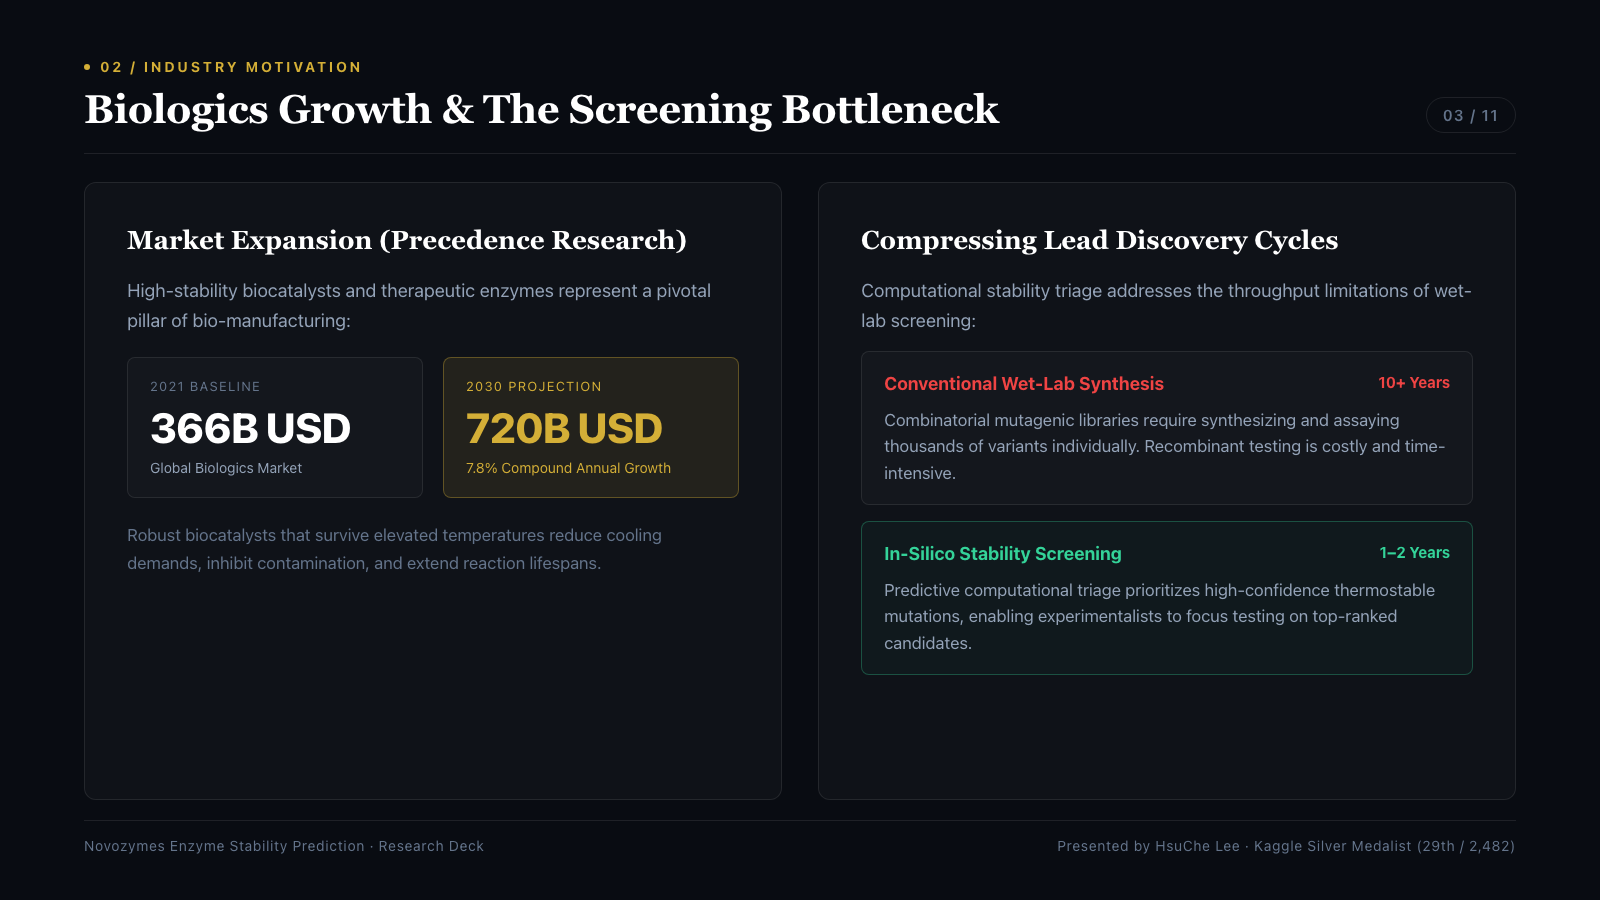
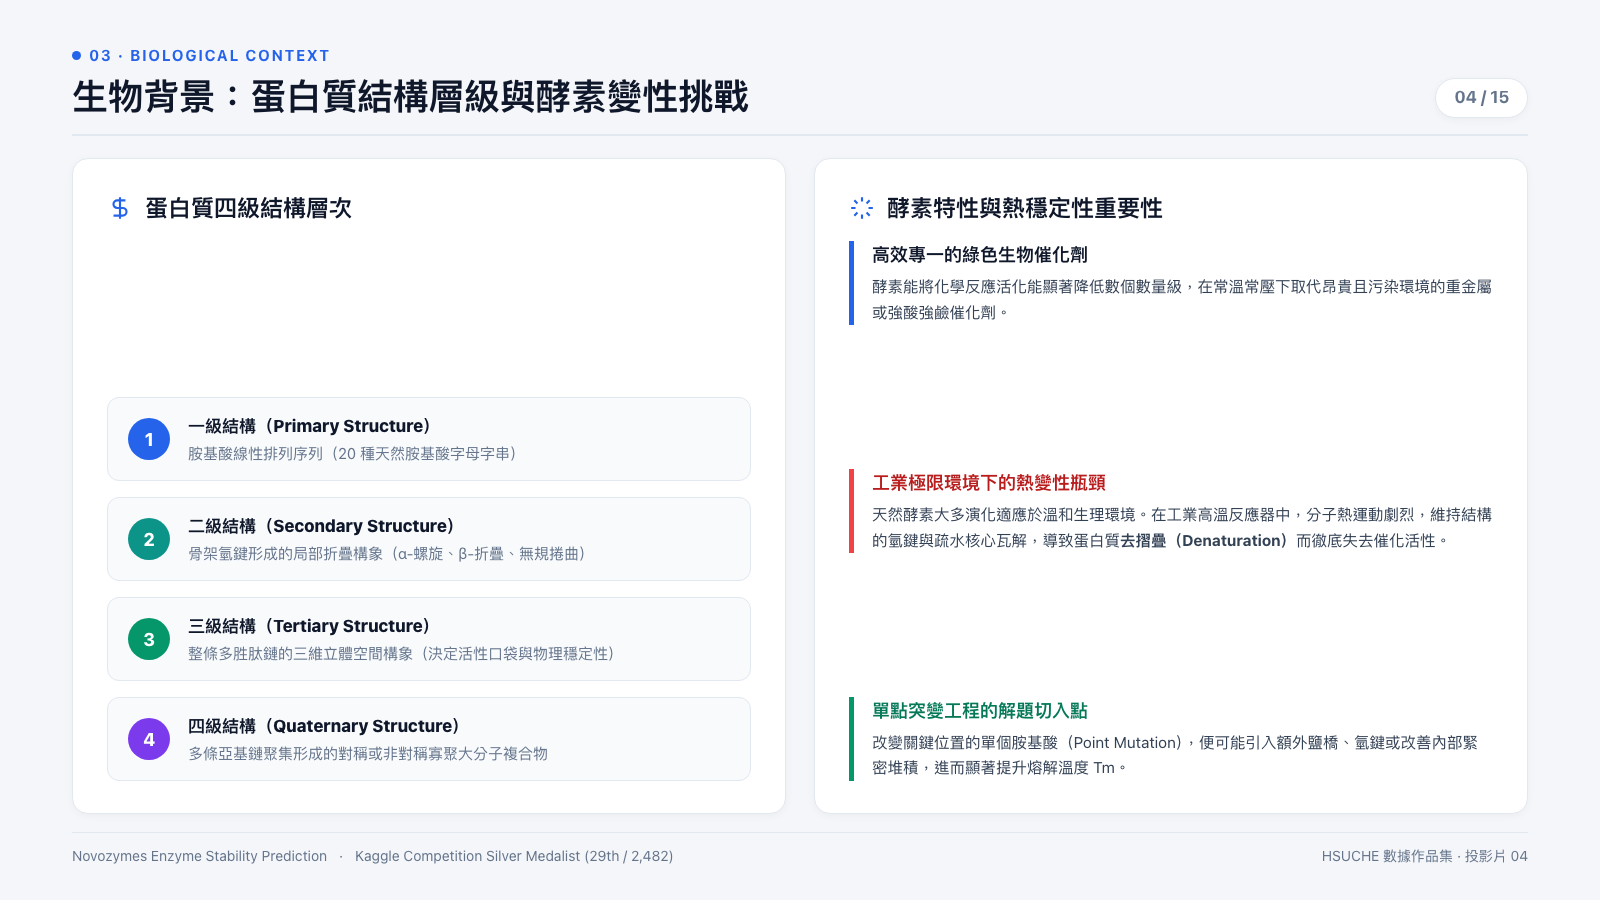
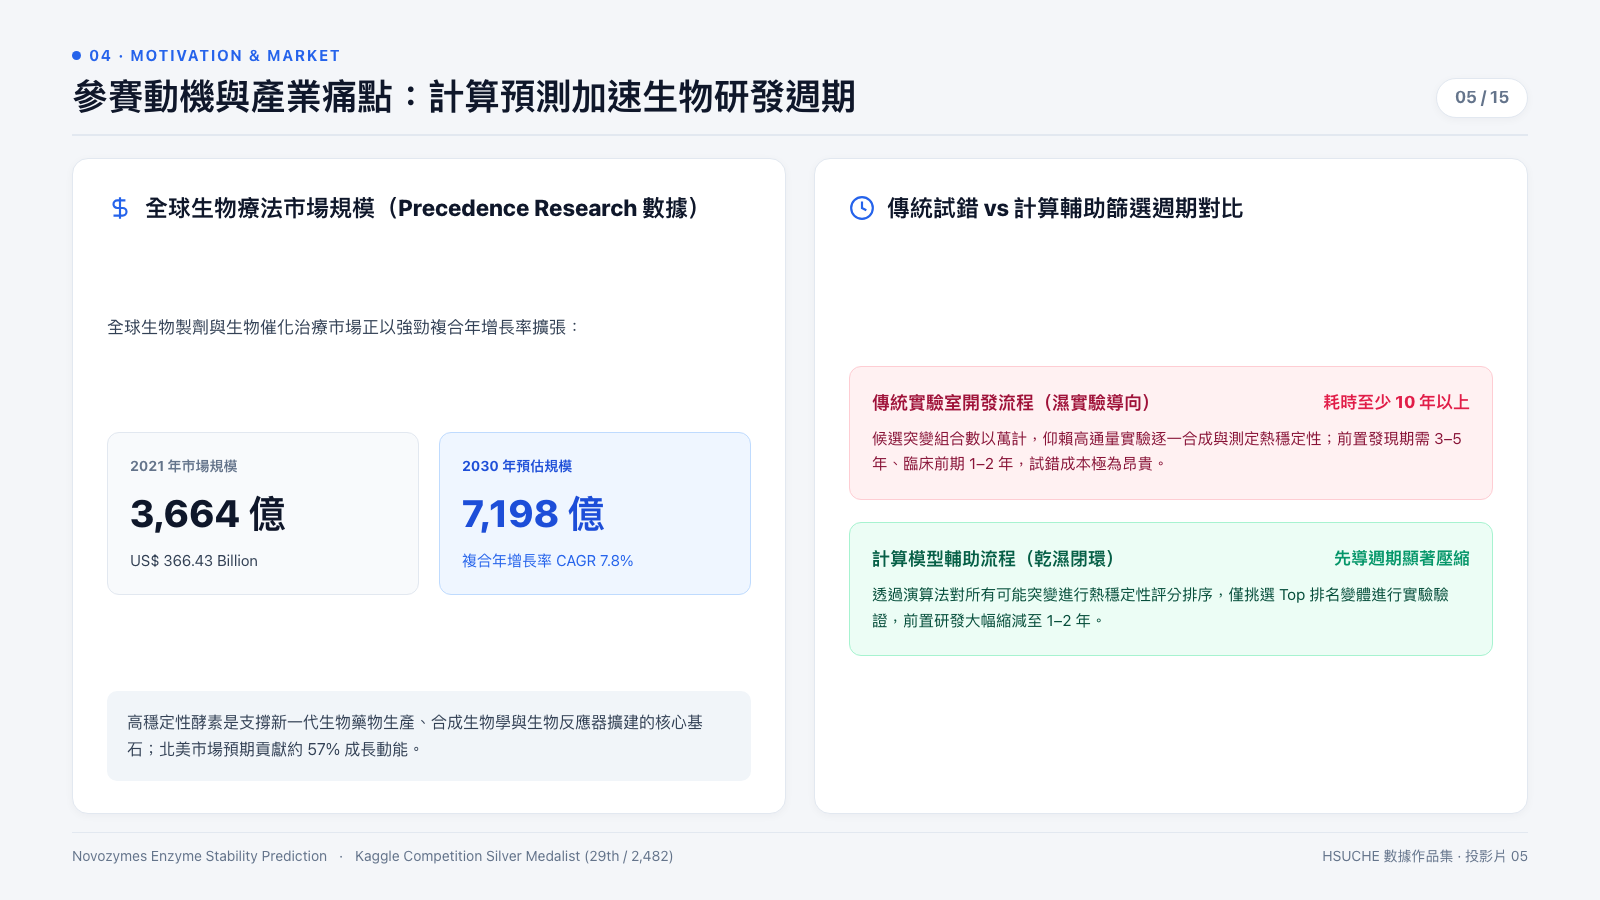
蛋白質是由胺基酸長鏈摺疊而成的三維立體大分子,其中具備催化生理化學反應功能的稱為酵素(Enzyme)。在生質能源、醫藥生產、食品加工與清潔洗劑等現代綠色化學工業中,酵素是不可或缺的生物催化劑;然而天然酵素大多適應溫和的生理環境,在工業生產的高溫或極端酸鹼條件下容易變性失活。如何透過計算模型評估並挑選出具備高耐熱特性的突變體,是蛋白質工程的核心課題。
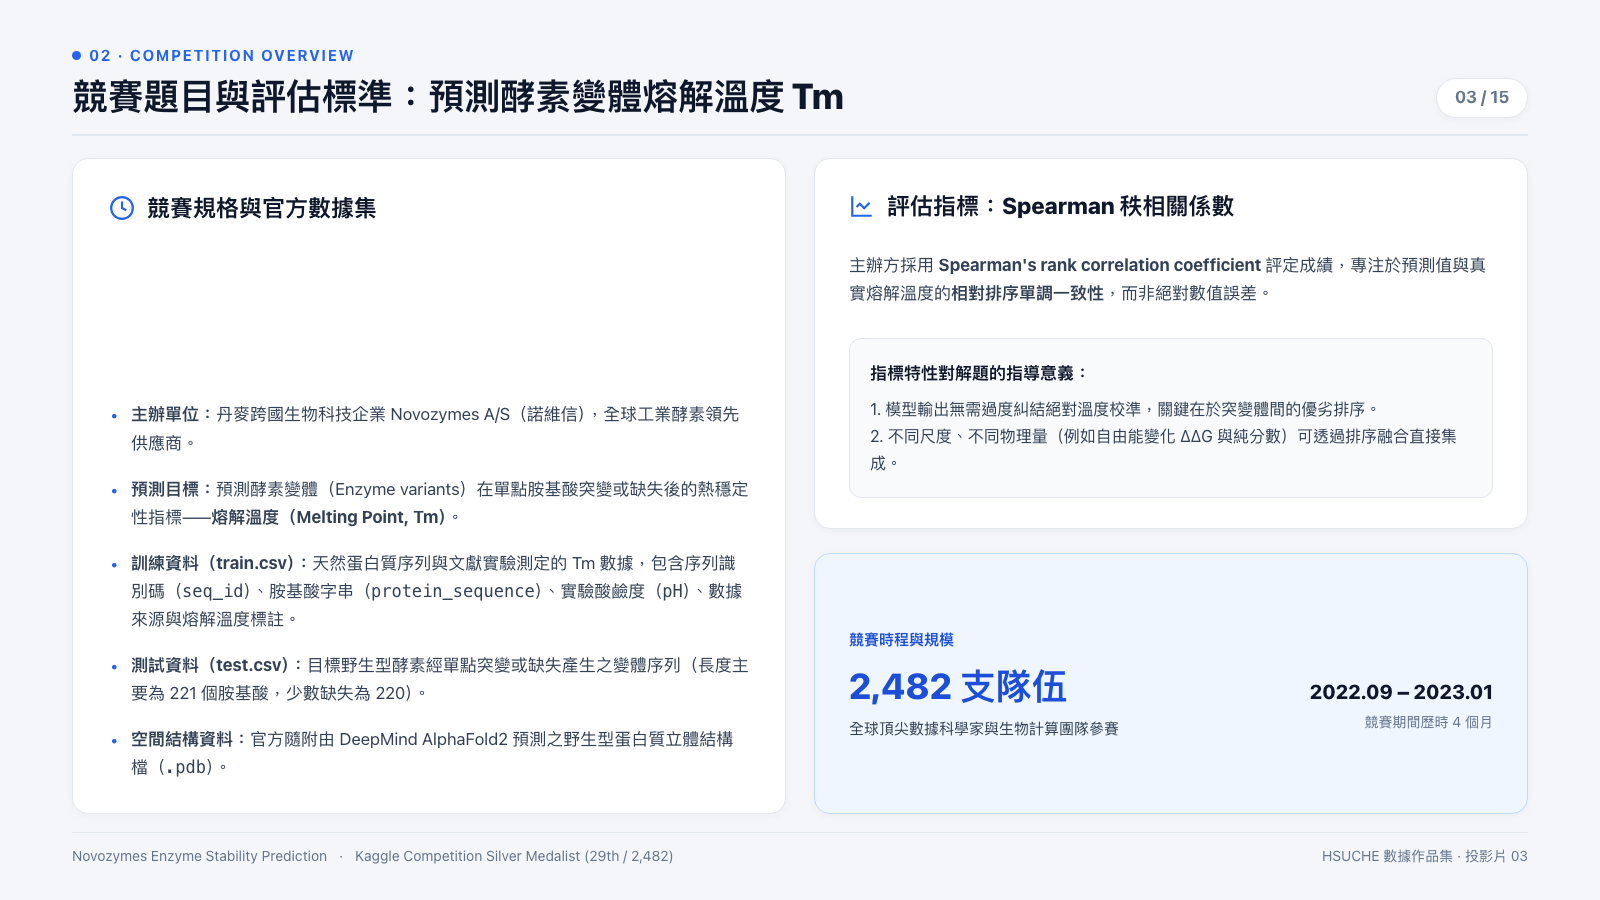
「Novozymes Enzyme Stability Prediction」由全球工業酵素領導廠商丹麥諾維信(Novozymes A/S)於 Kaggle 平台舉辦,競賽核心規格如下:
- 主辦單位:Novozymes A/S(丹麥生物技術跨國企業諾維信)。
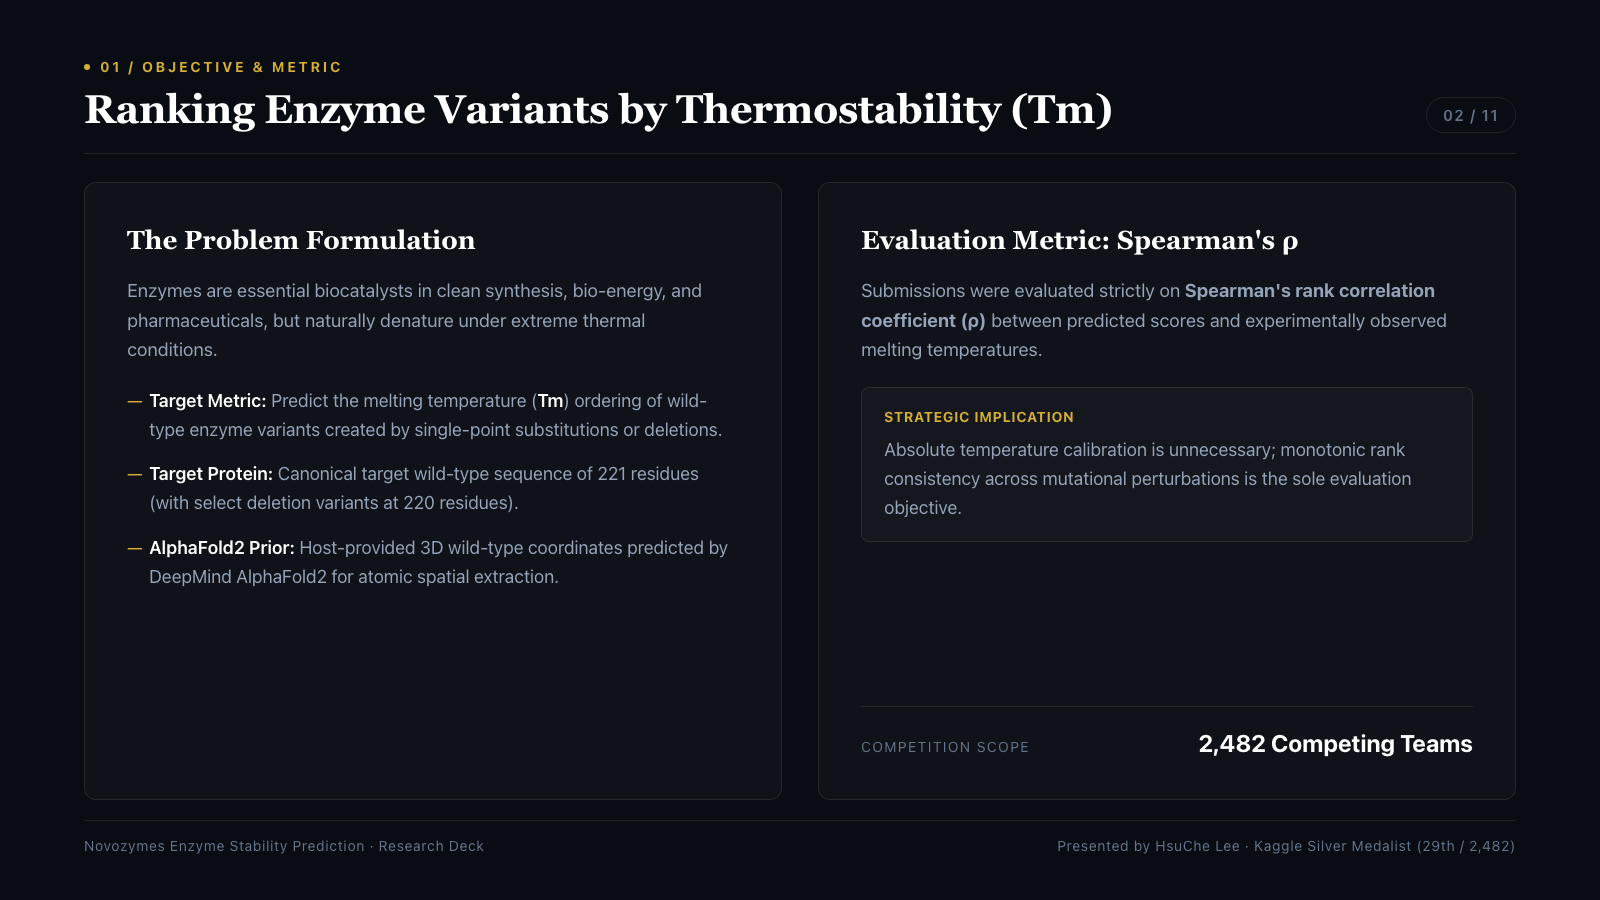
- 預測目標:預測酵素變體(Enzyme variants)在單點胺基酸突變或缺失後的熱穩定性,以實驗測定的熔解溫度(Melting Point, Tm)相對排序為衡量基準。模型輸出變體的相對耐熱排序分數,協助實驗人員在實際合成前先篩選出高潛力候選體。
- 競賽資料形式:
train.csv:天然蛋白質序列與文獻實驗測定的熱穩定性數據,包含序列識別碼(seq_id)、胺基酸序列字串(protein_sequence)、實驗酸鹼度(pH)、實驗數據來源(data_source,如 Meltome Atlas)以及熔解溫度目標值(tm)。官方賽中另提供train_updates_20220929.csv修正數據標註。test.csv:競賽測試集,由野生型酵素經單點突變或缺失所產生之變體組成,長度主要為 221 個胺基酸(少數缺失變體為 220 個胺基酸),包含seq_id、protein_sequence與pH。wildtype_structure_prediction_af2.pdb:官方隨附由 DeepMind AlphaFold2 所預測的野生型酵素三維立體結構檔案,供參賽者提取蛋白質空間結構特徵。
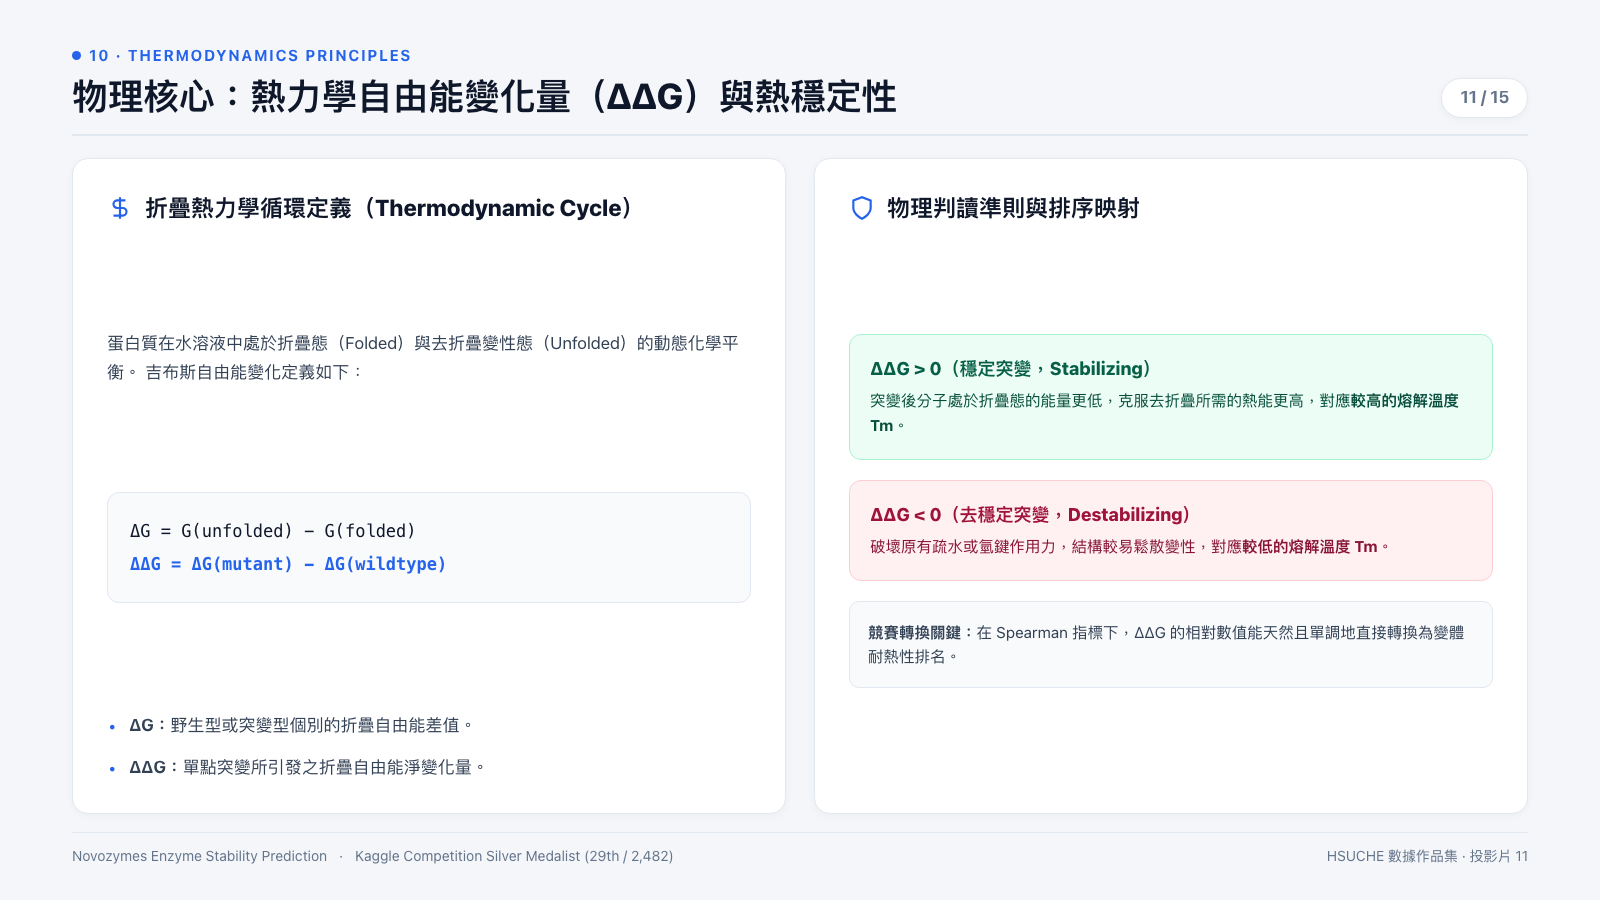
- 評估指標:Spearman 秩相關係數(Spearman's rank correlation coefficient)。評估預測排序與真實熔解溫度的單調相對關係,而非單純的絕對溫度數值誤差。
- 競賽時程:2022 年 9 月 21 日至 2023 年 1 月 3 日(UTC)。
- 參賽規模:全球共 2,482 支隊伍參賽(以 Kaggle 官方結賽最終排行榜與證書為準;1,331 隊為賽期中途進度數字)。
03 · Methods
解題方法:四條技術路線與多模型集成
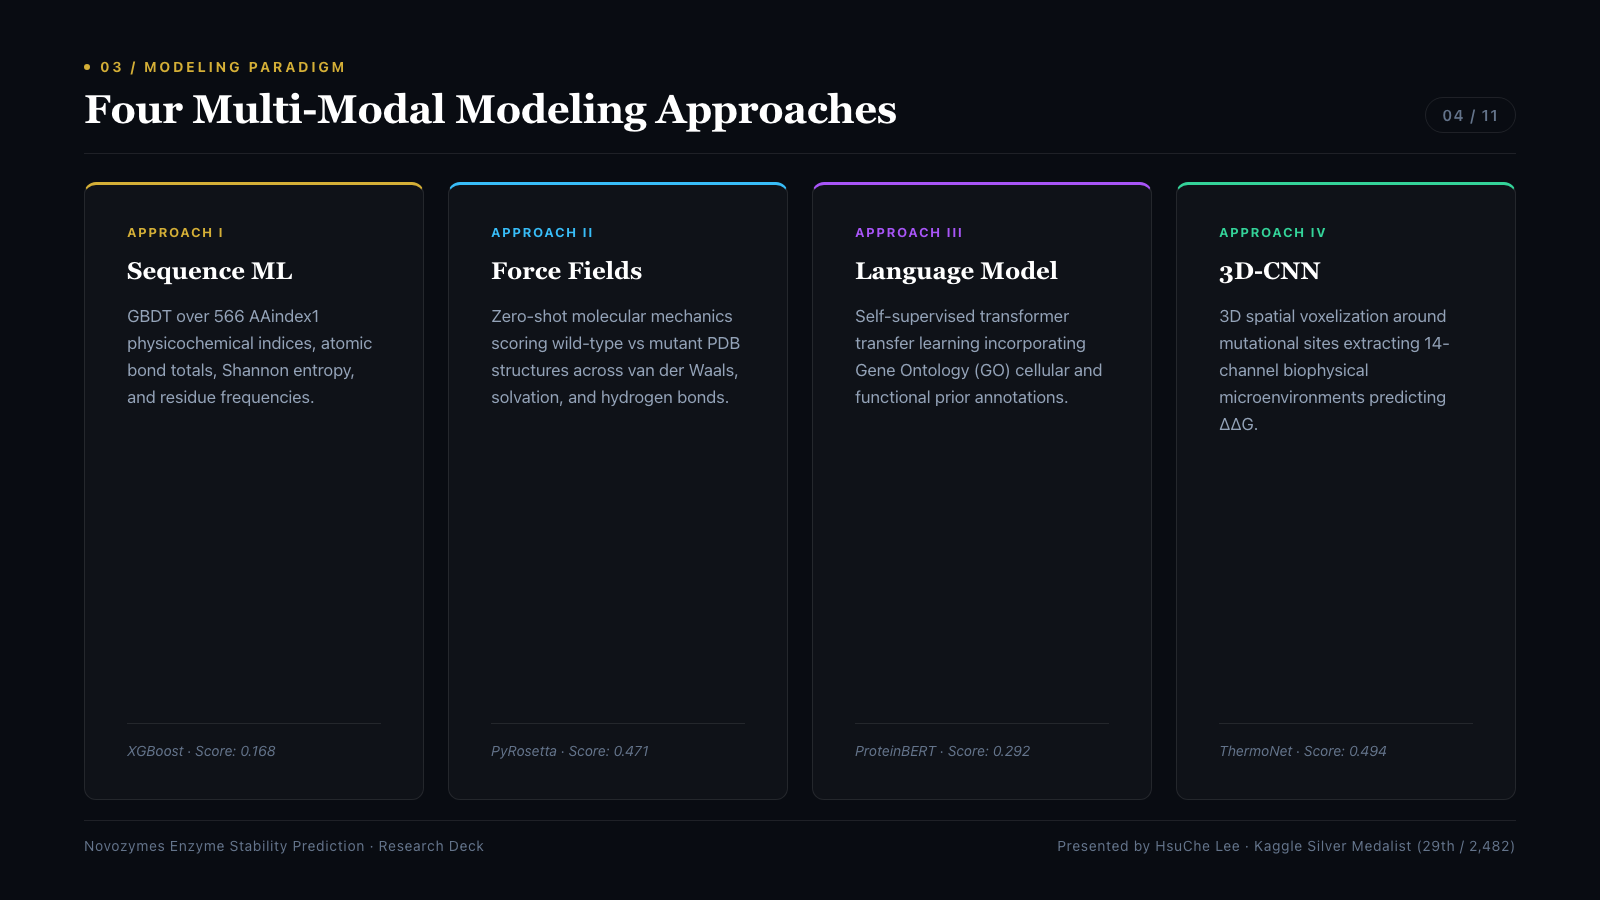
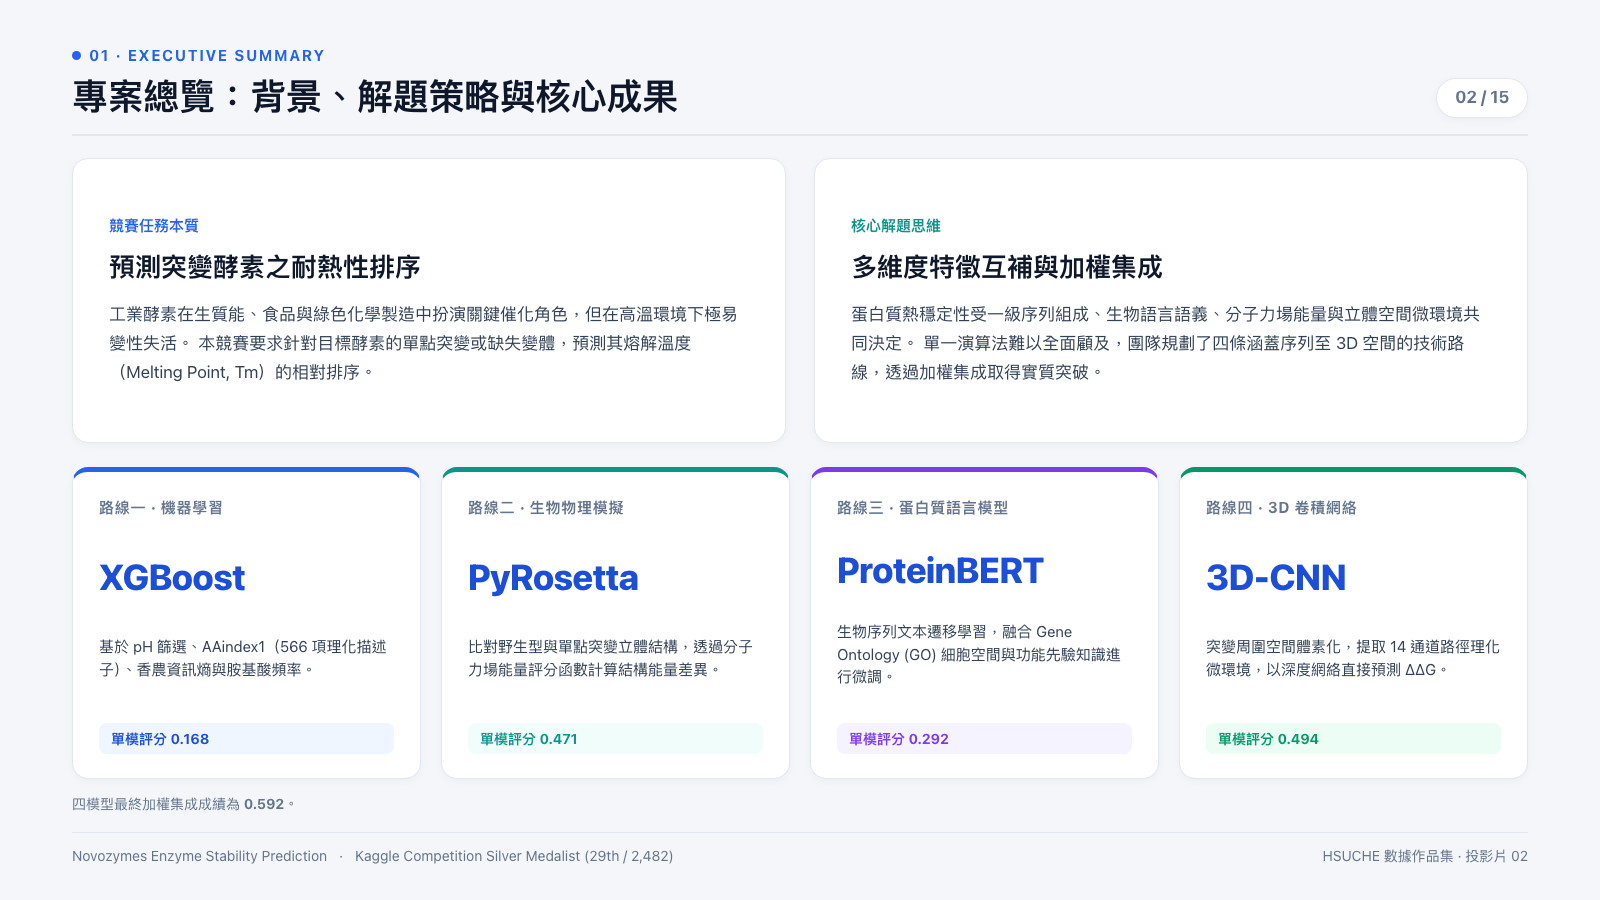
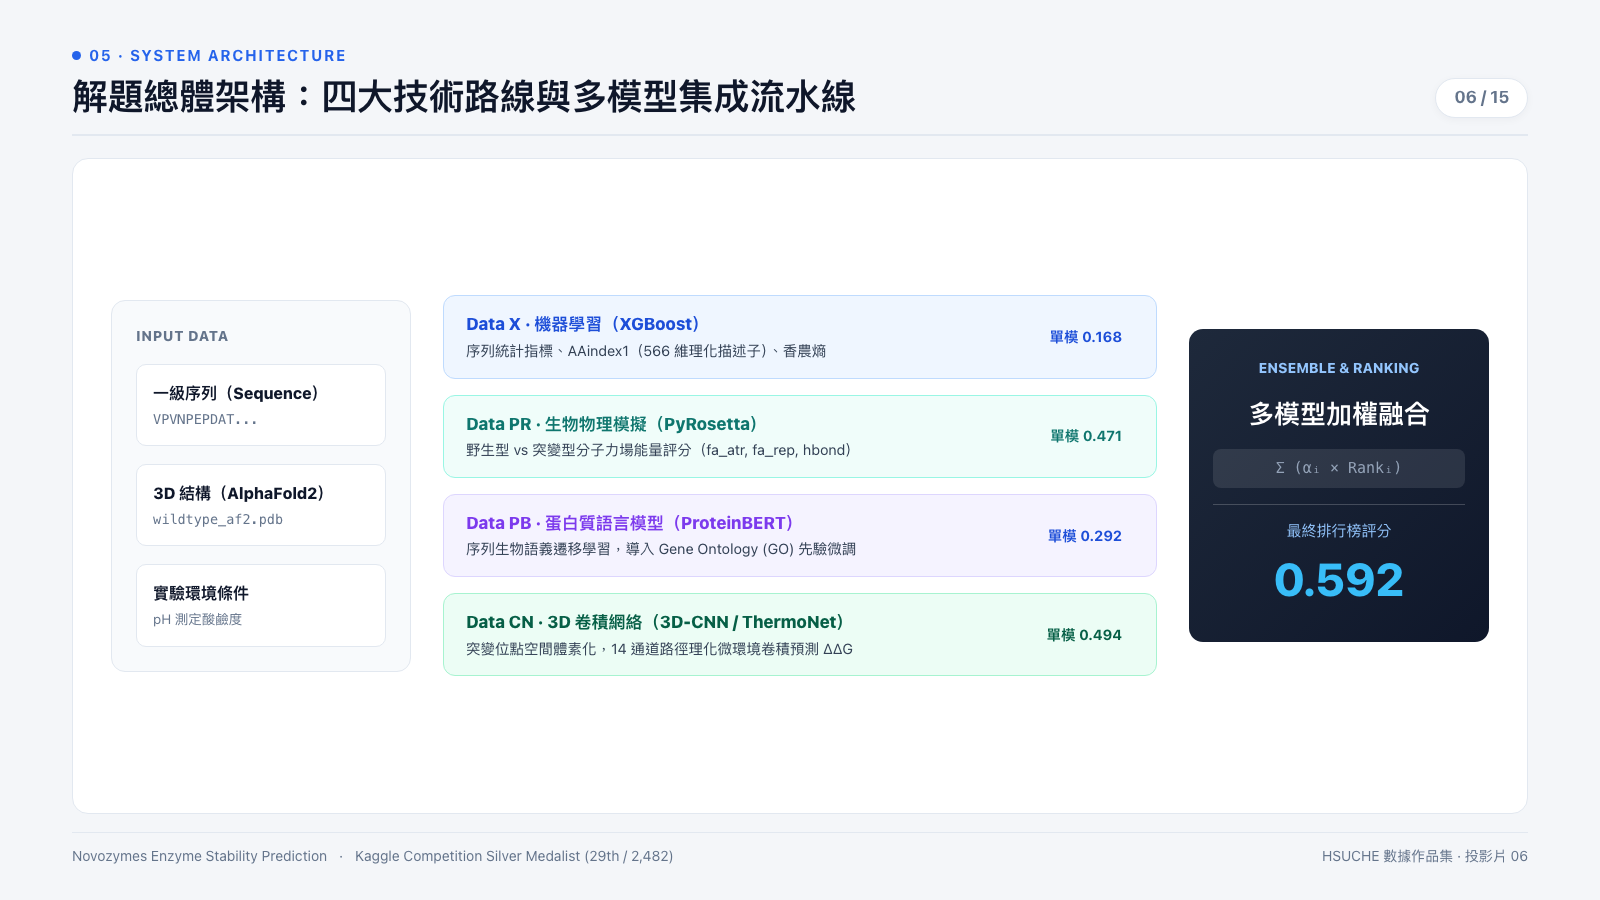
蛋白質的熱穩定性變化受到一級序列化學組成、局部生物語義、三維立體構形與分子間物理力場等多重維度交互影響。單一演算法難以全面顧及所有維度,因此本專案規劃了四條涵蓋不同層次的技術路線,最終透過加權集成(Weighted Ensemble)進行全局排序:
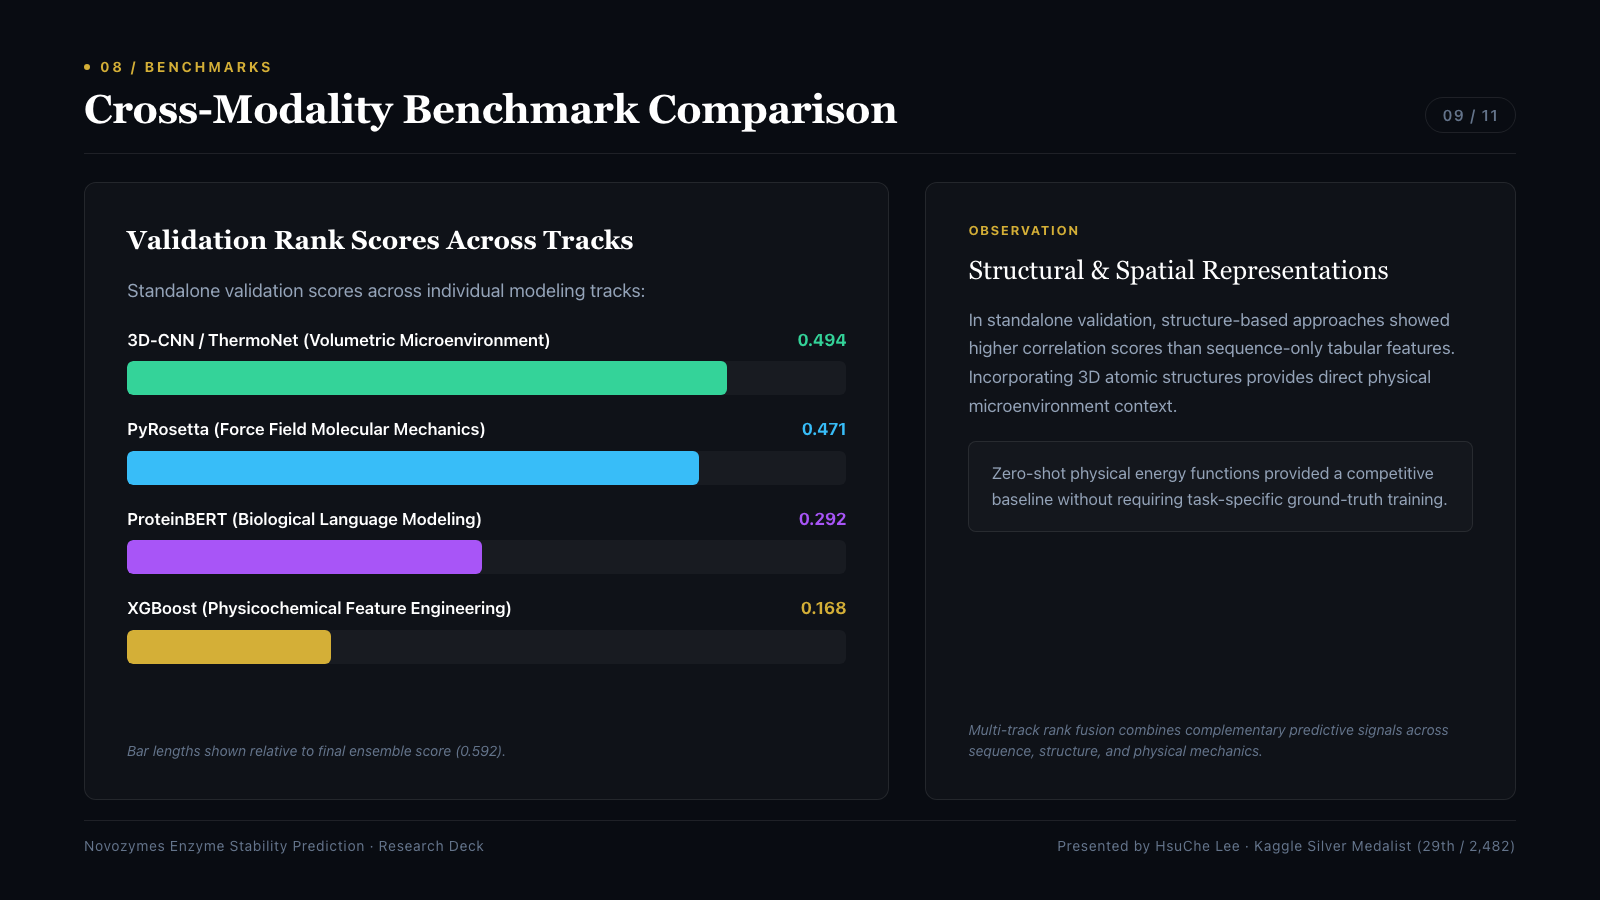
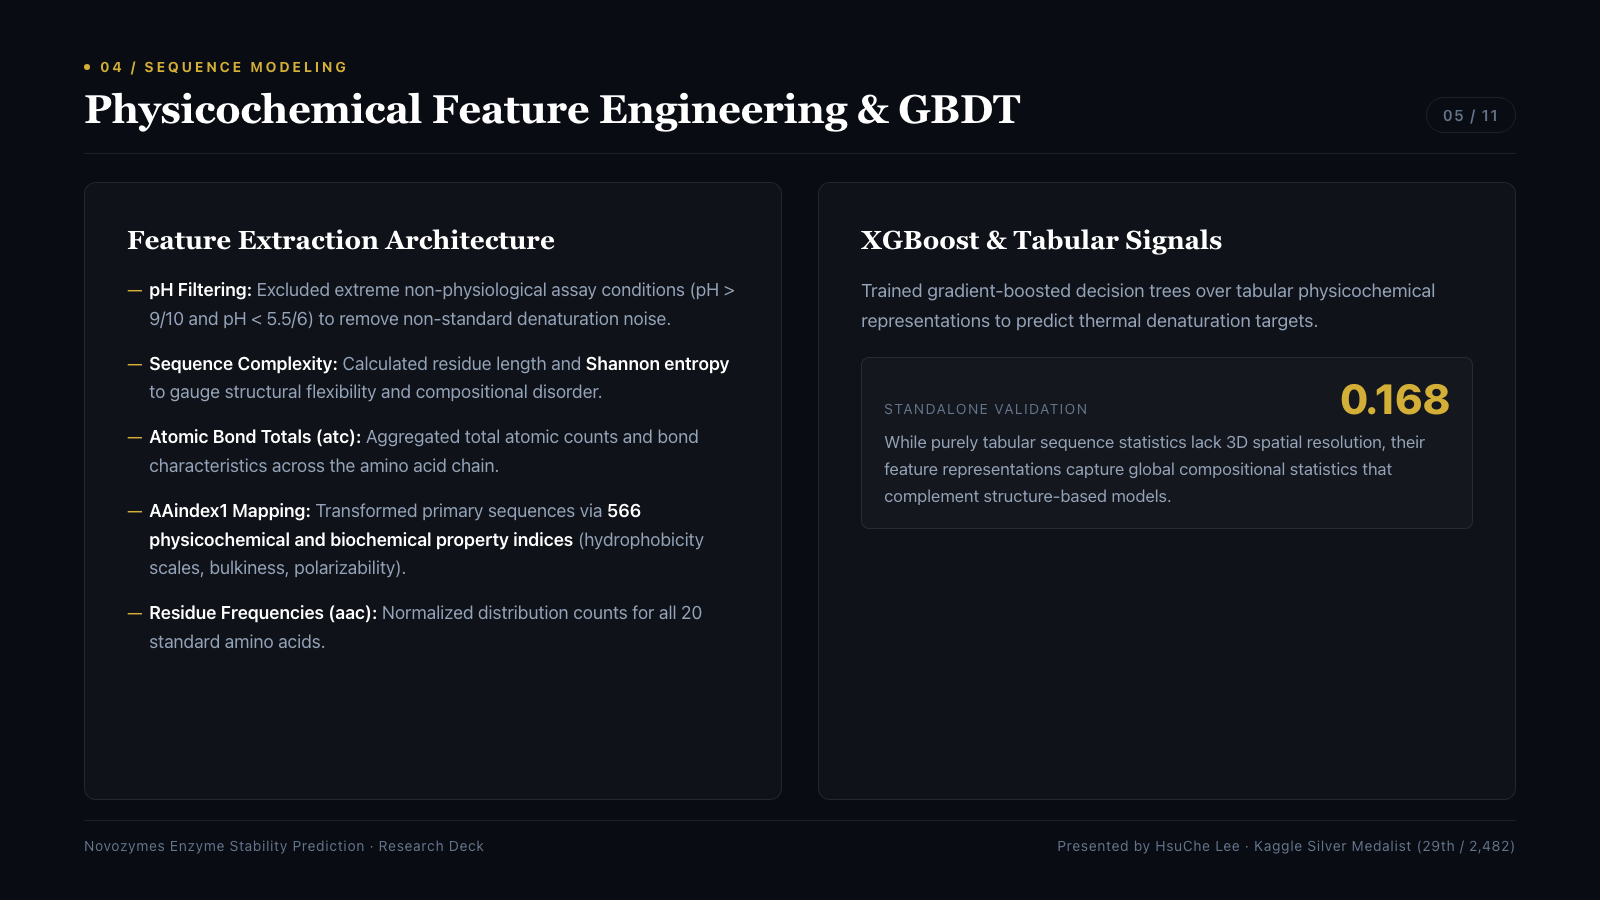
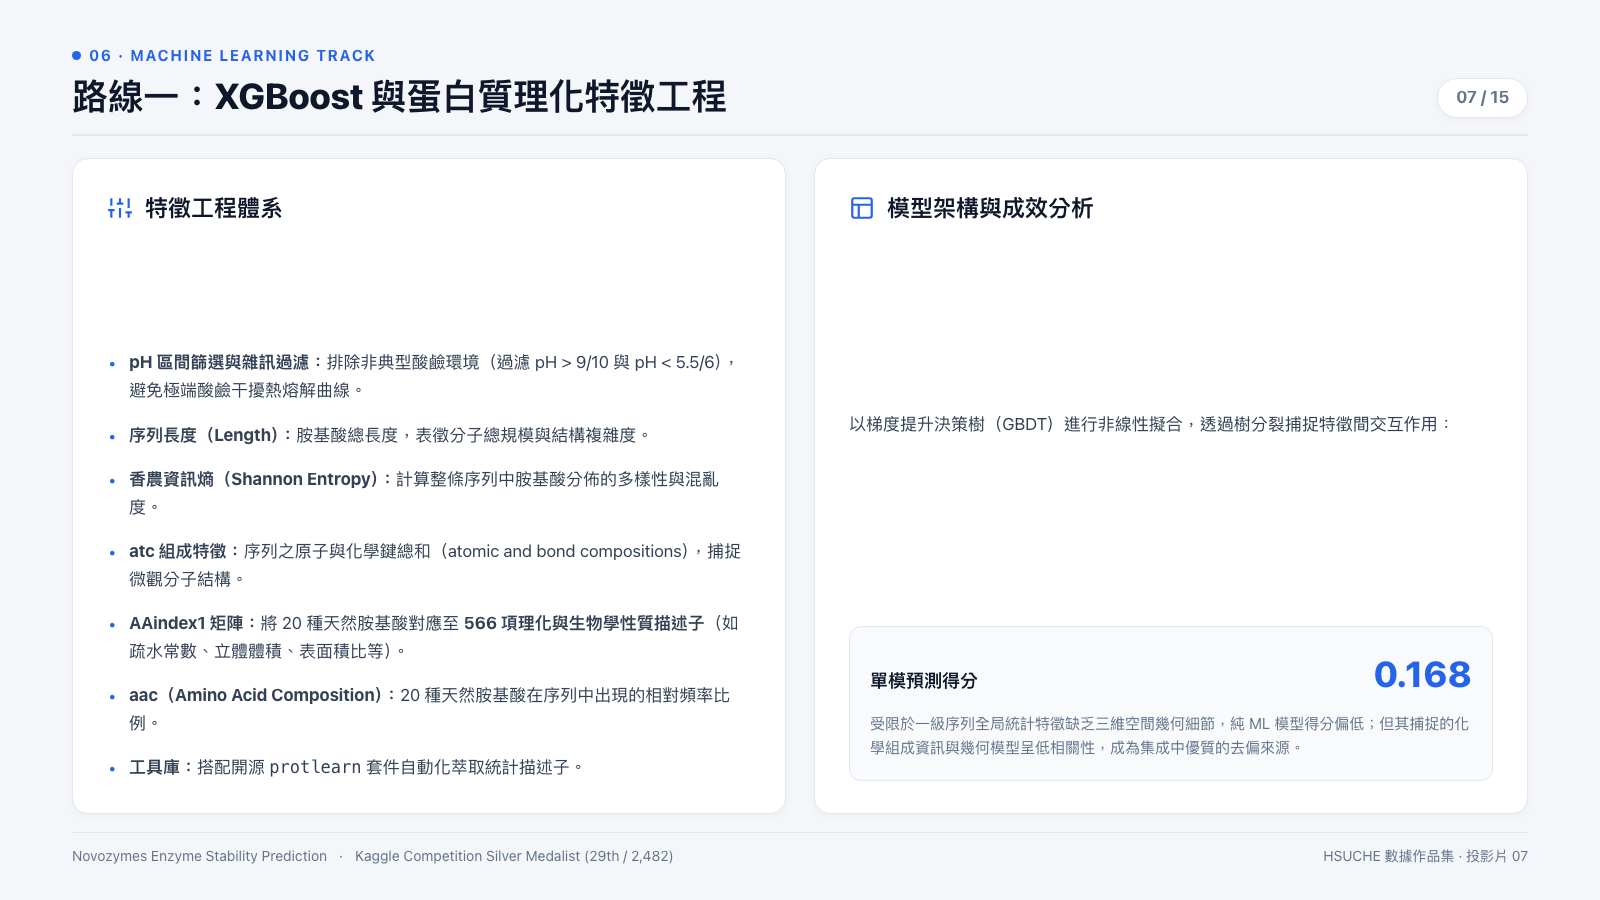
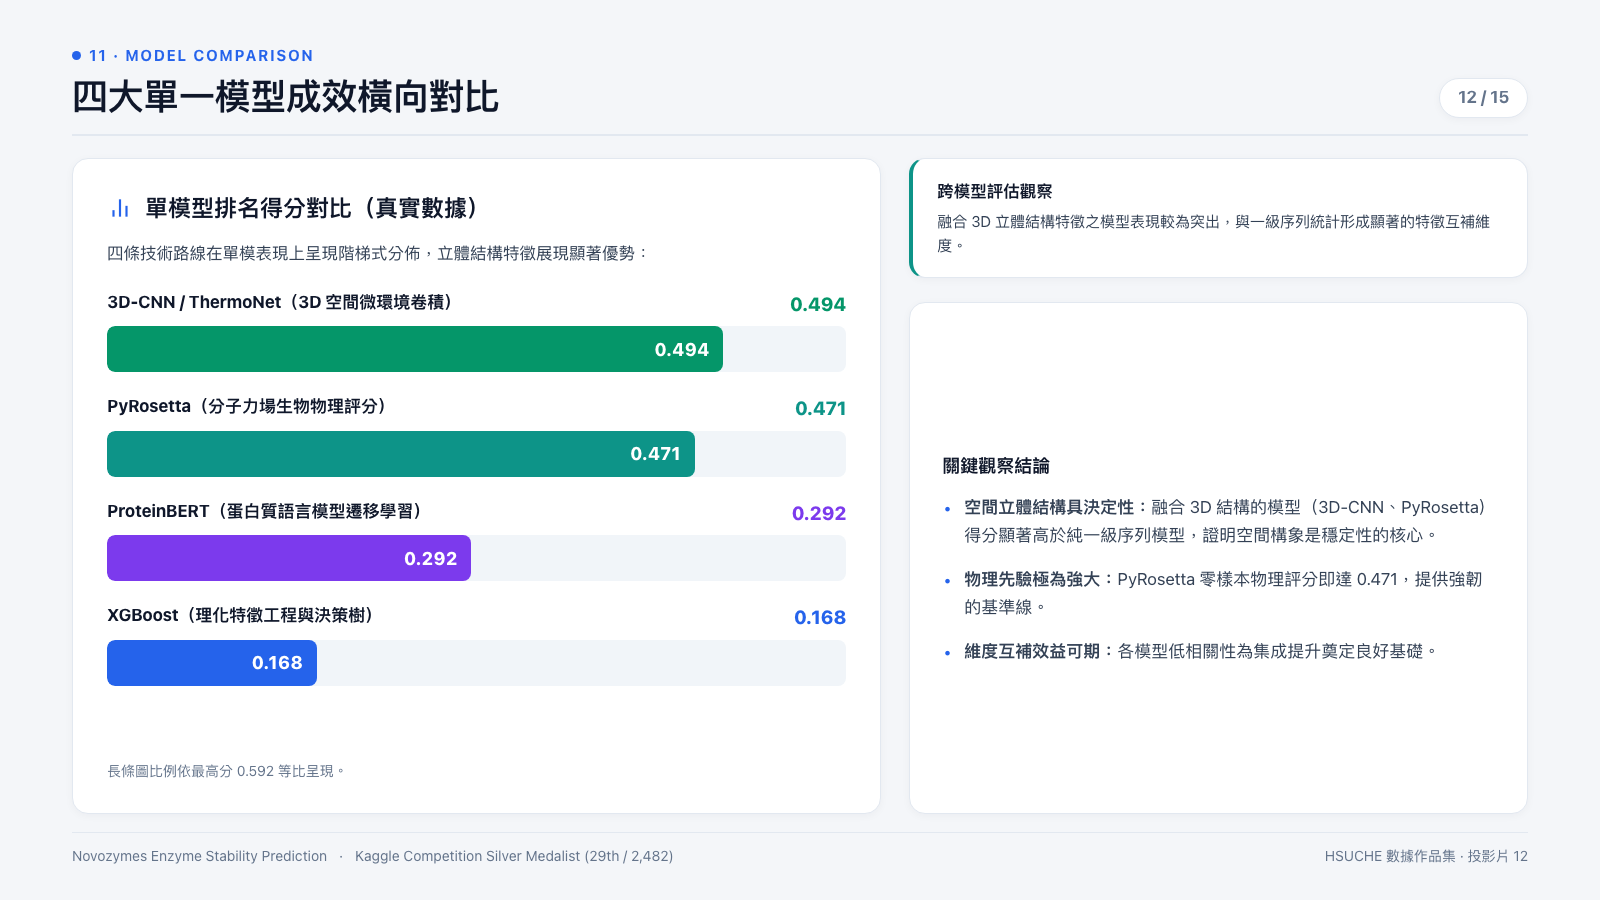
理化特徵工程與資料清理:過濾極端酸鹼值條件的雜訊(過濾 pH > 9/10 與 pH < 5.5/6)。提取序列長度、香農資訊熵(反映序列複雜度)、atc(原子與化學鍵總和)、AAindex1(對應 566 項理化與生物學性質描述子)與 aac(20 種胺基酸出現頻率),並搭配 protlearn 套件提取特徵,訓練 GBDT 模型預測熔解溫度。單模排名得分:0.168。
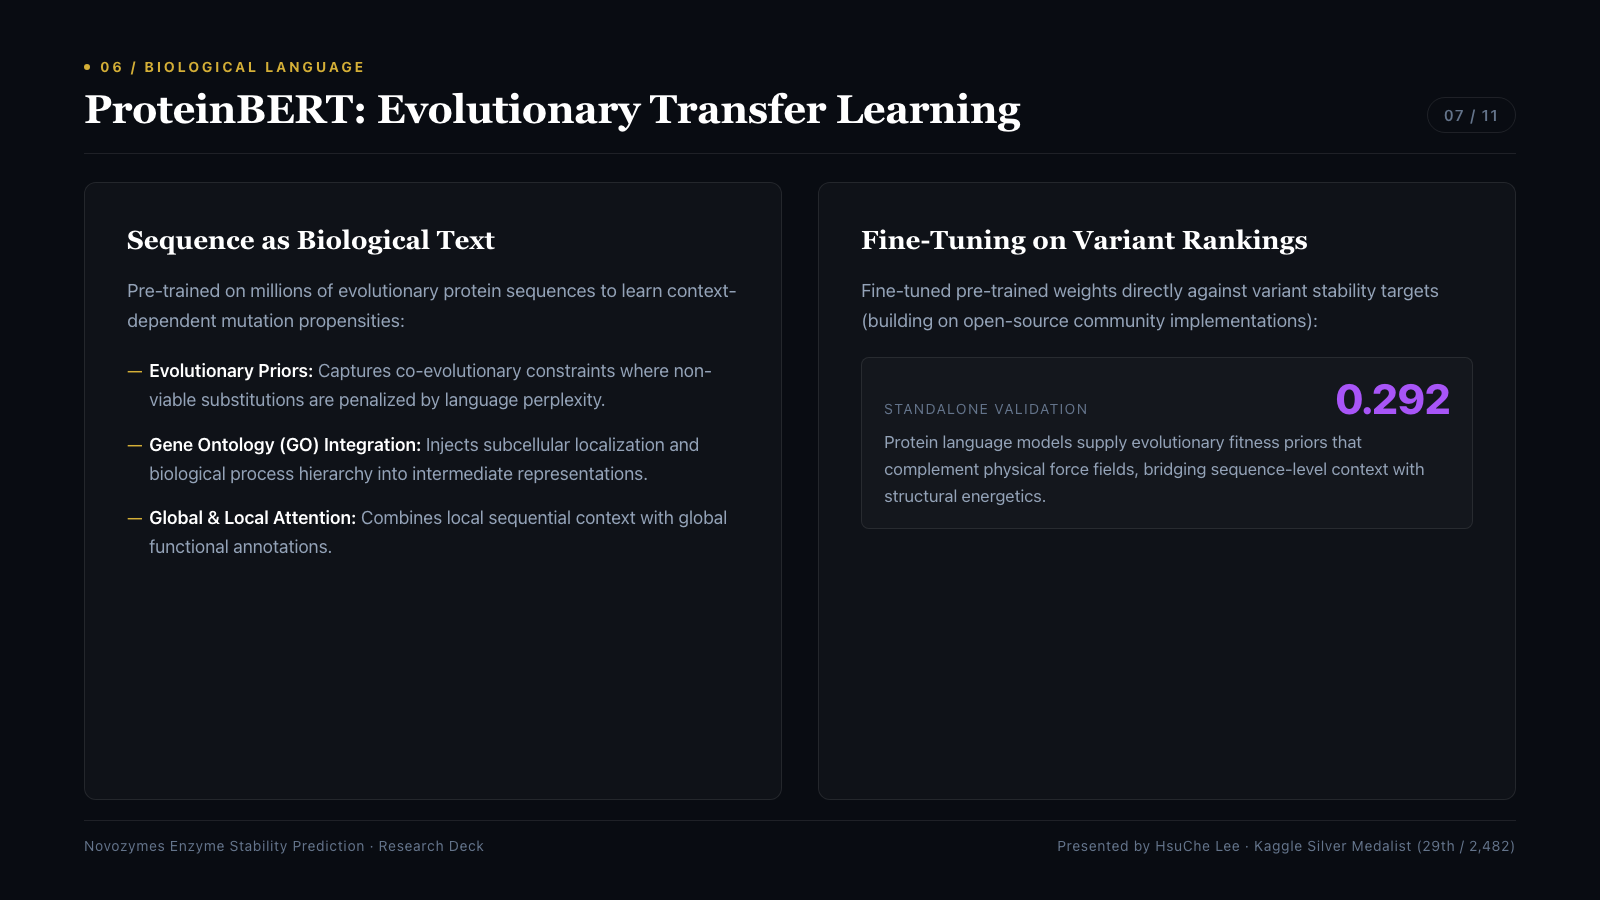
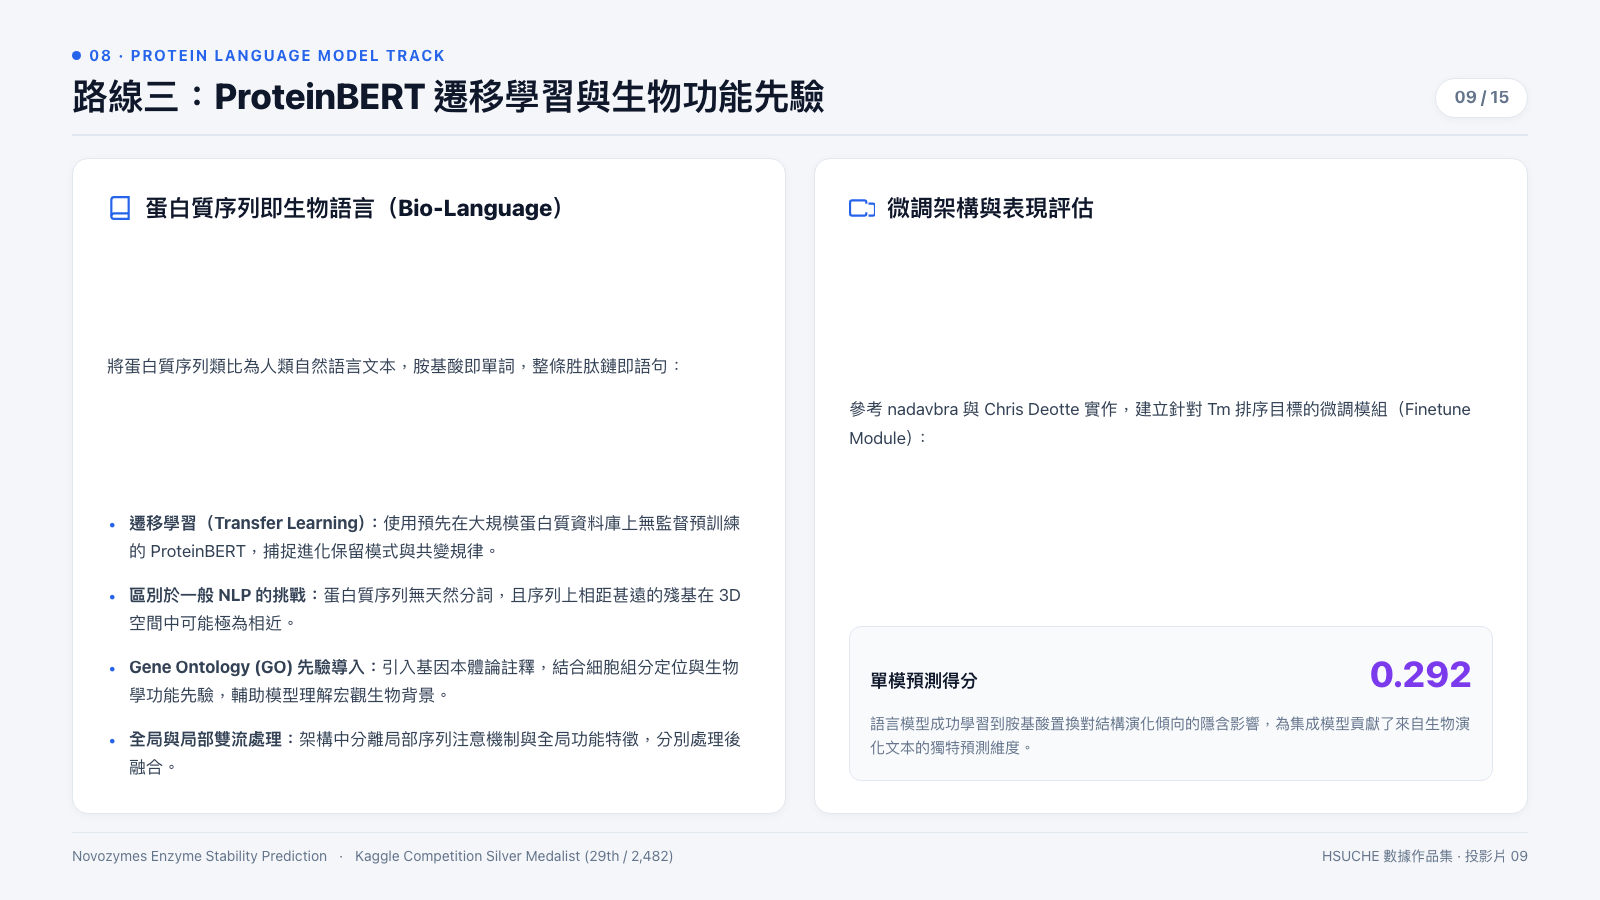
生物語言遷移學習:將蛋白質胺基酸序列視為生物文本,採用預訓練的 ProteinBERT 架構進行遷移學習;導入基因本體論(Gene Ontology, GO)融合細胞定位與生物功能先驗知識,經微調後直接輸出突變體排序評分(參考 nadavbra 之公開實作)。單模排名得分:0.292。
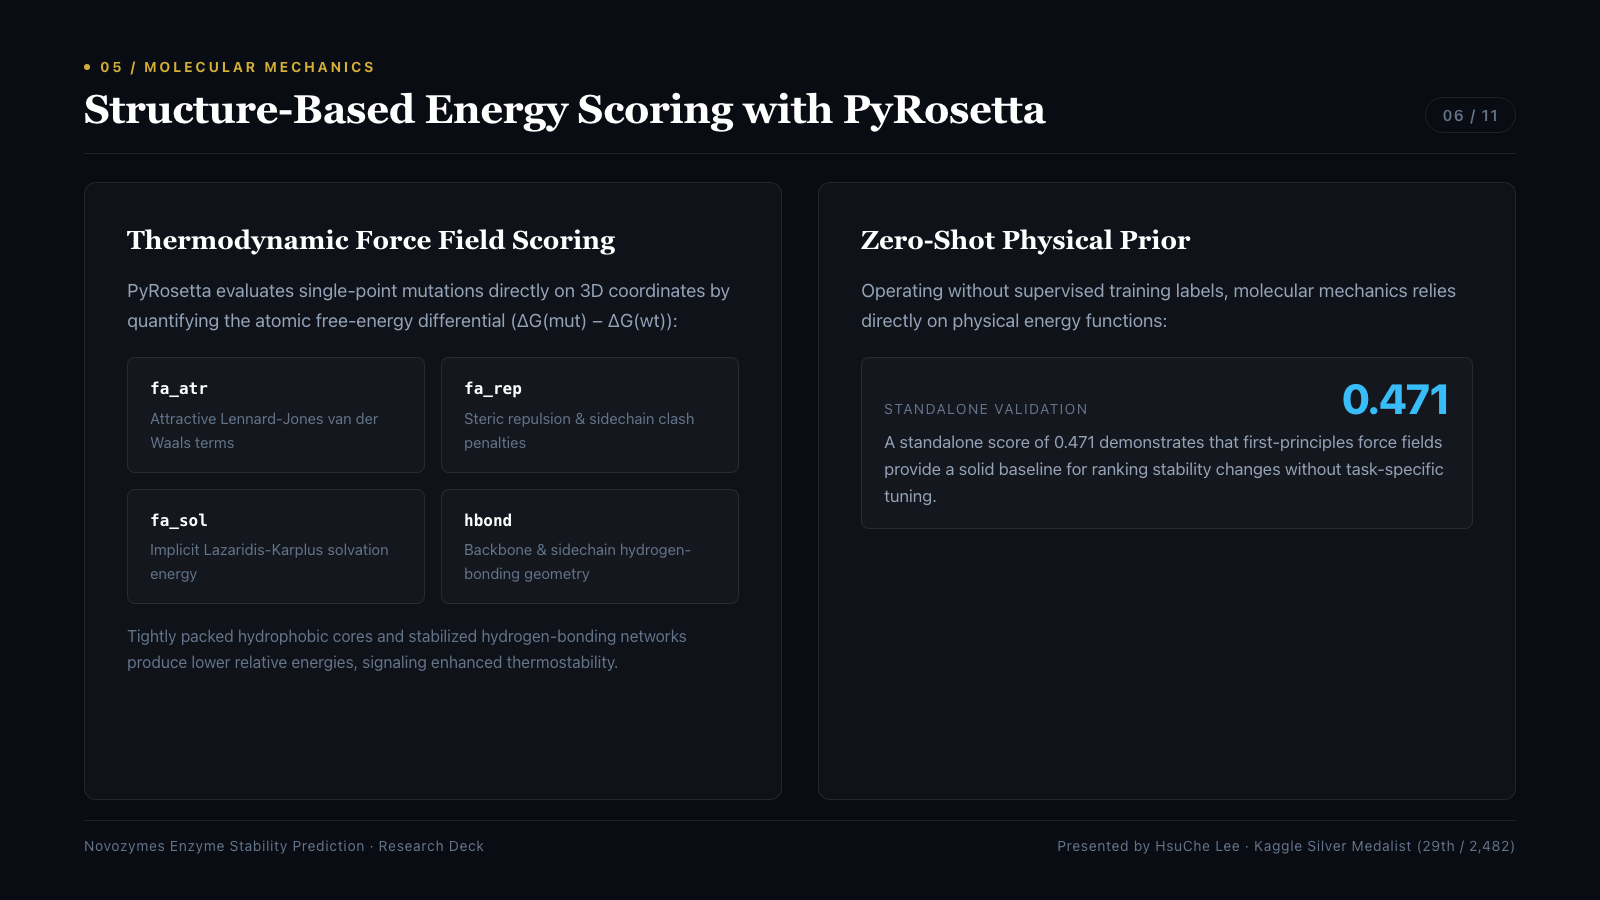
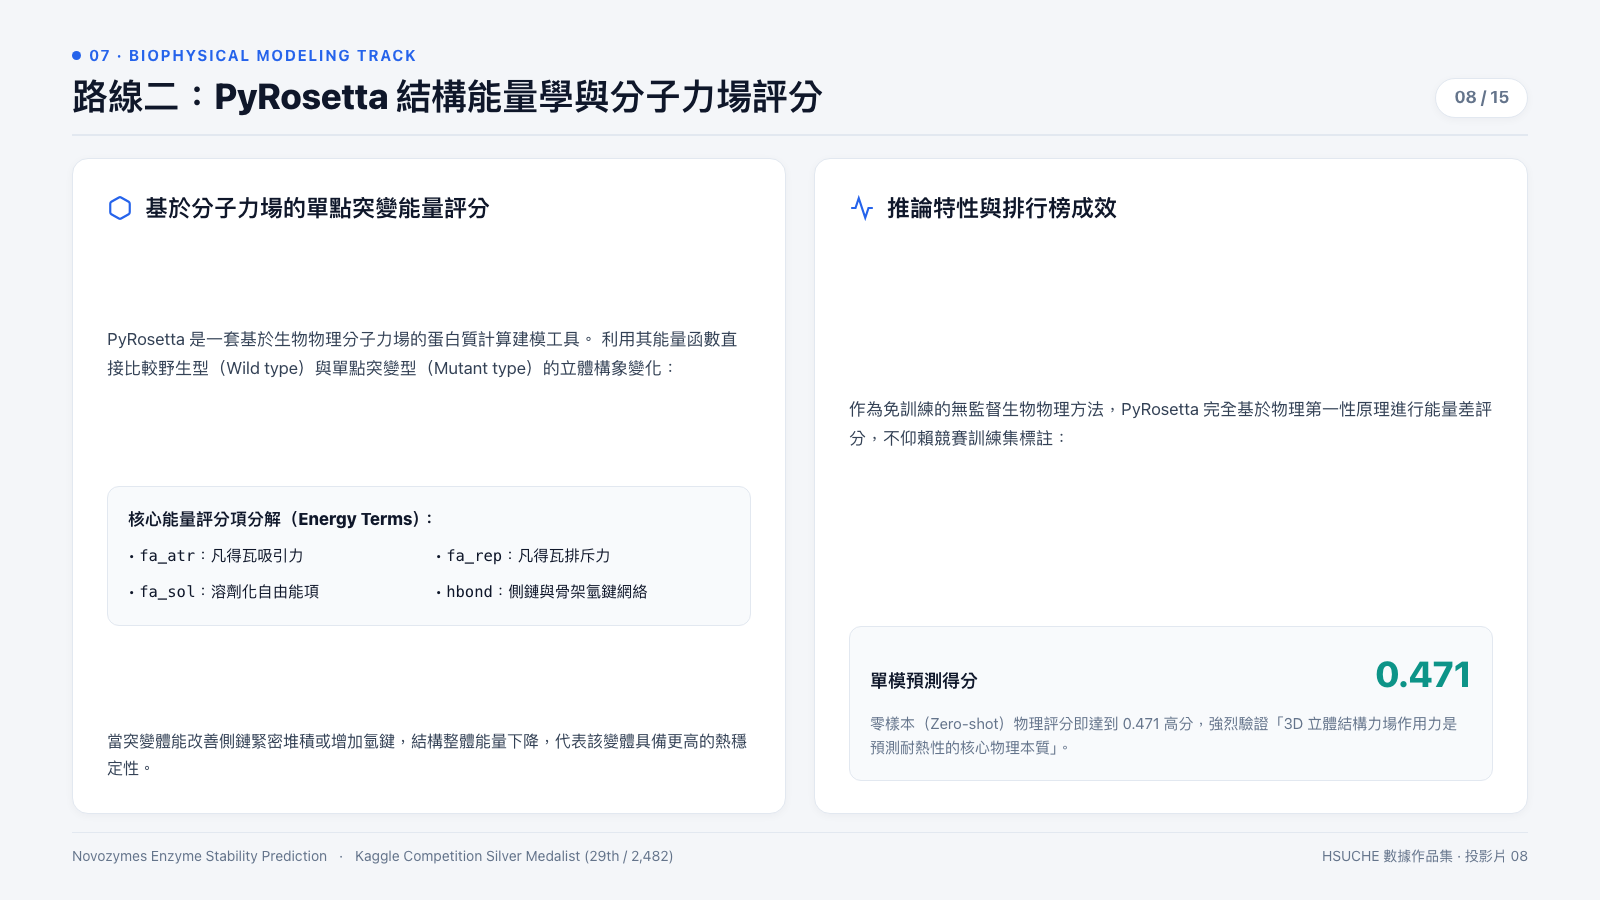
分子力場結構能量評分:基於蛋白質 3D 立體結構,利用結構建模工具 PyRosetta 比對野生型與單點突變型的空間構象,透過分子力場能量評分函數(包含凡得瓦吸引/排斥 fa_atr/fa_rep、溶劑化自由能 fa_sol、氫鍵 hbond 等物理項)計算突變引起的結構能量變化。單模排名得分:0.471。
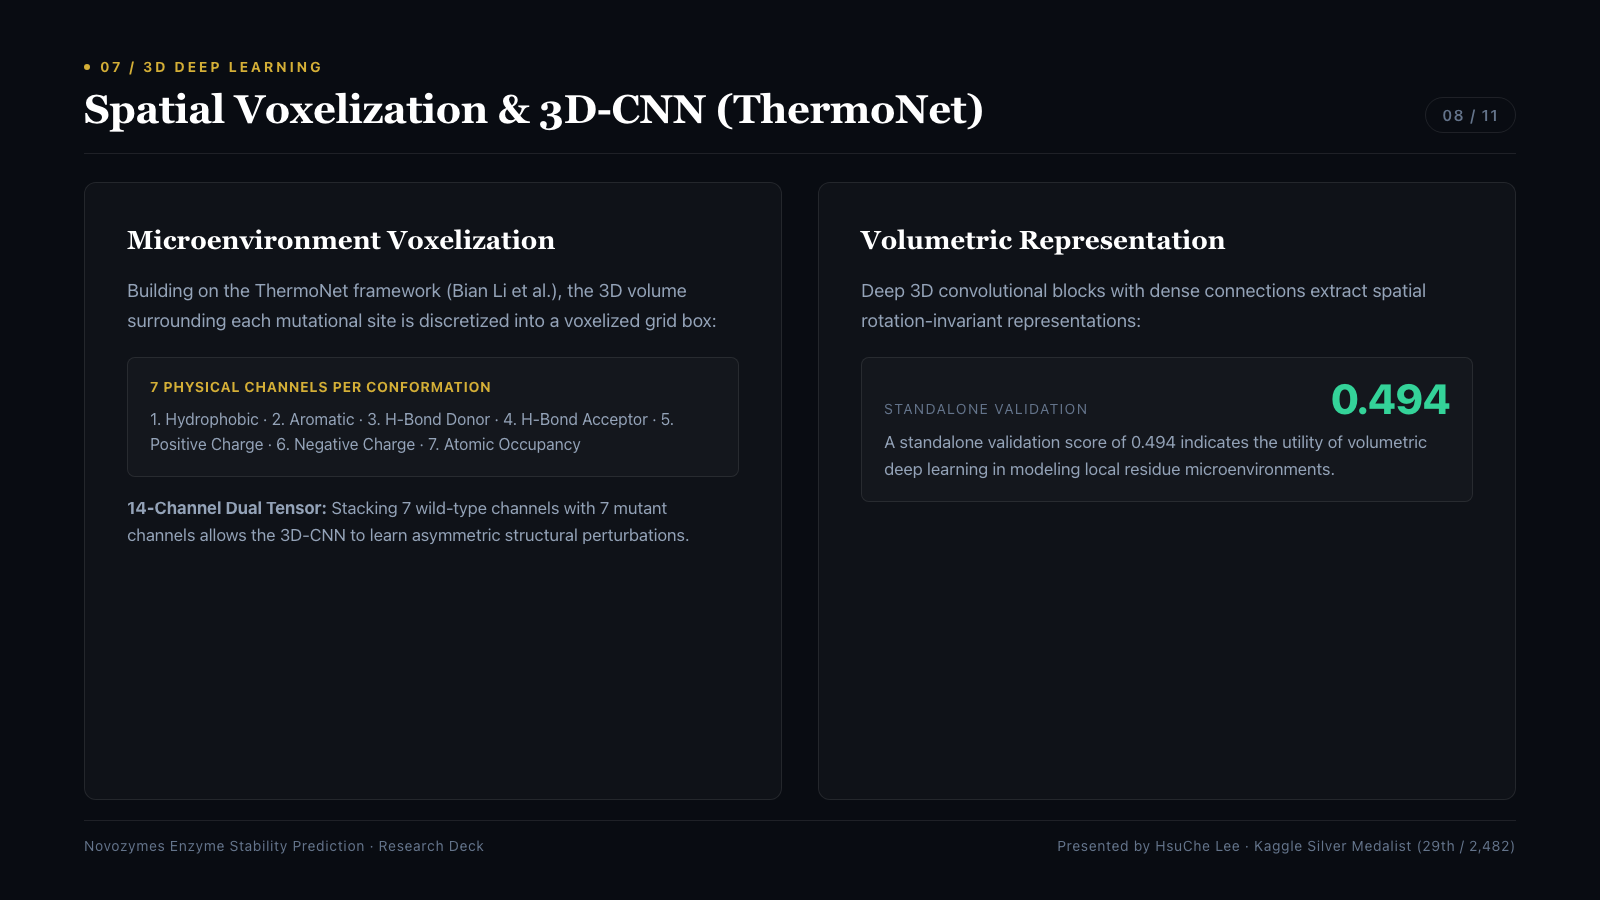
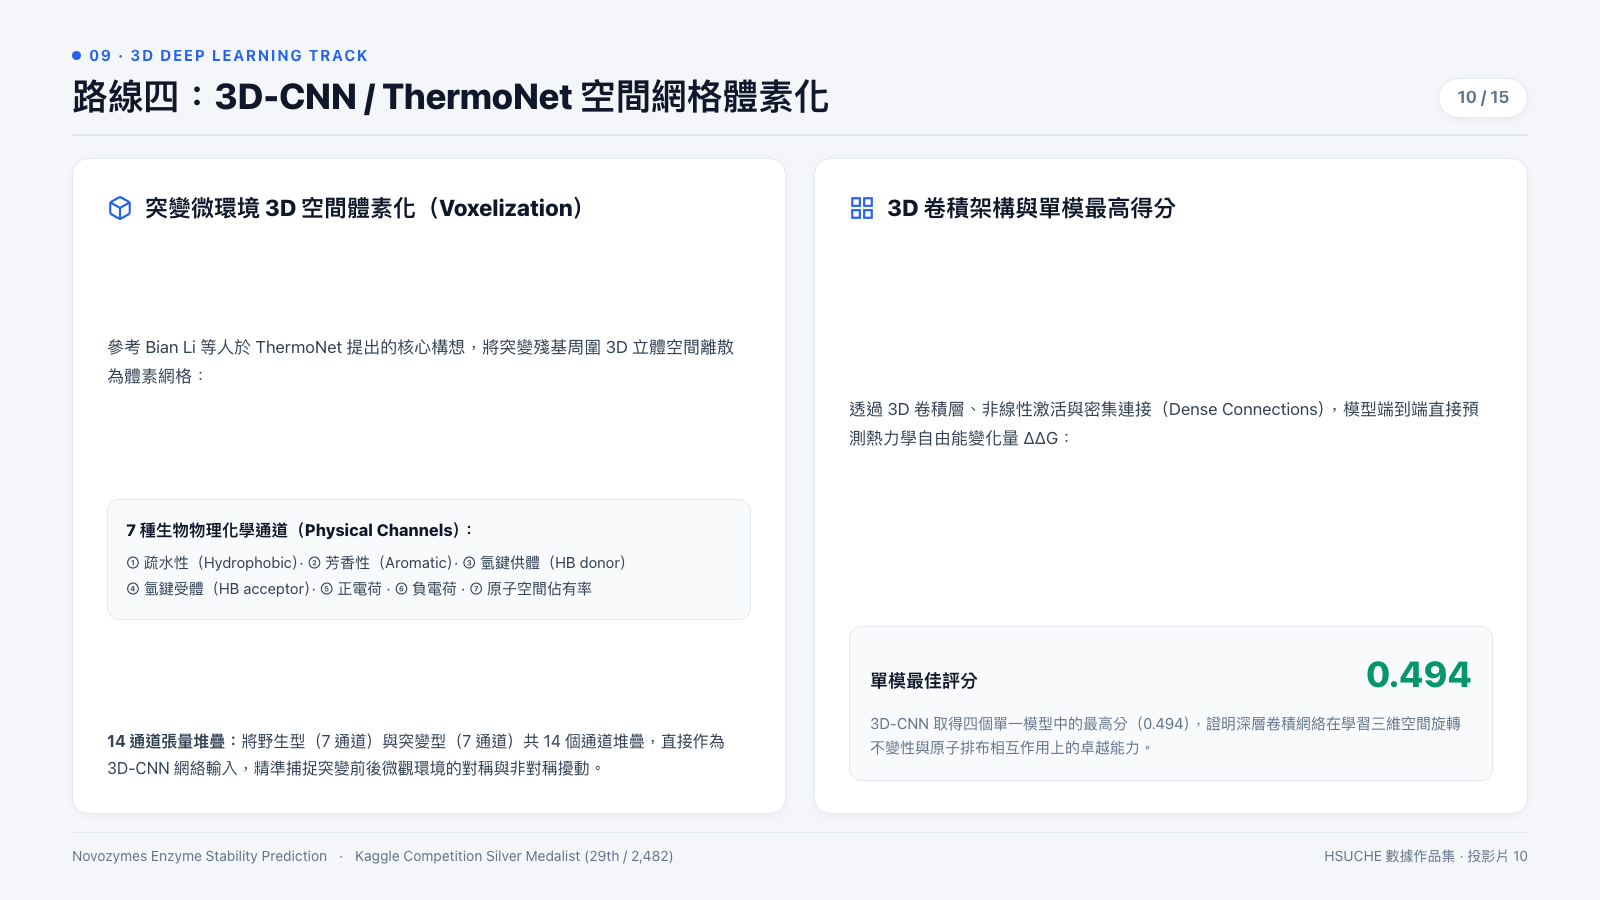
空間體素化與深度卷積:以蛋白質三維立體結構為基礎,將突變位點周圍空間進行體素化(Voxelization)建立 3D 網格,提取疏水性、芳香性、氫鍵供體、氫鍵受體、正負電荷與空間佔有率等 7 種生物物理特徵通道,並疊加野生型與突變型共 14 通道,輸入 3D 卷積神經網絡直接預測自由能變化量 ΔΔG(依 Bian Li et al. 之 ThermoNet 架構)。單模排名得分:0.494。
模型集成與最終排名(Ensemble)
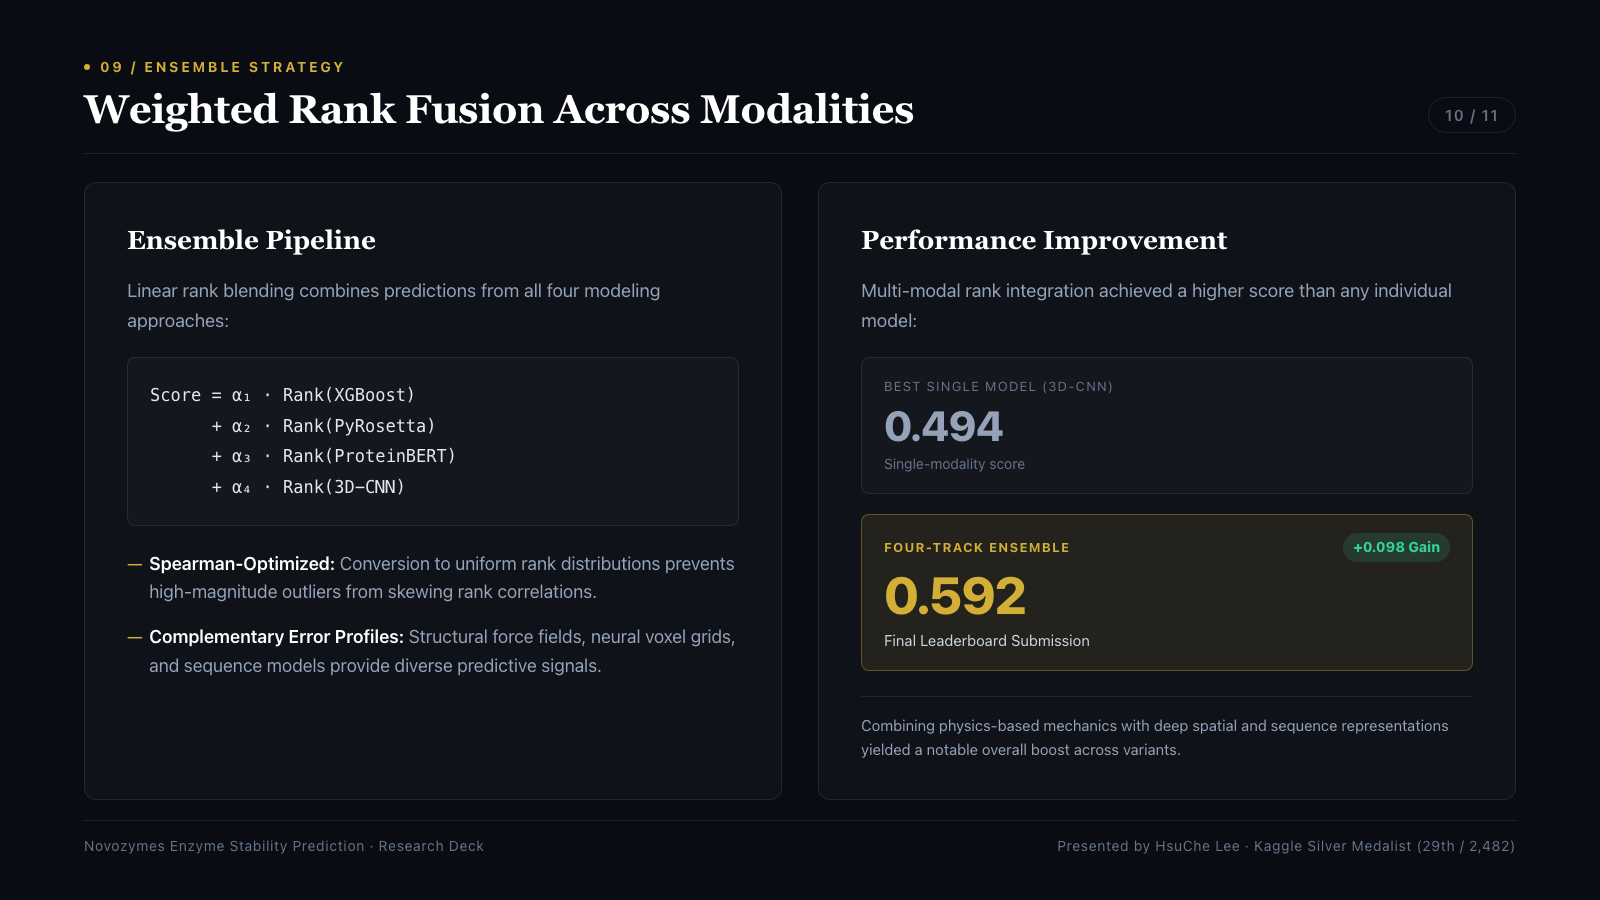
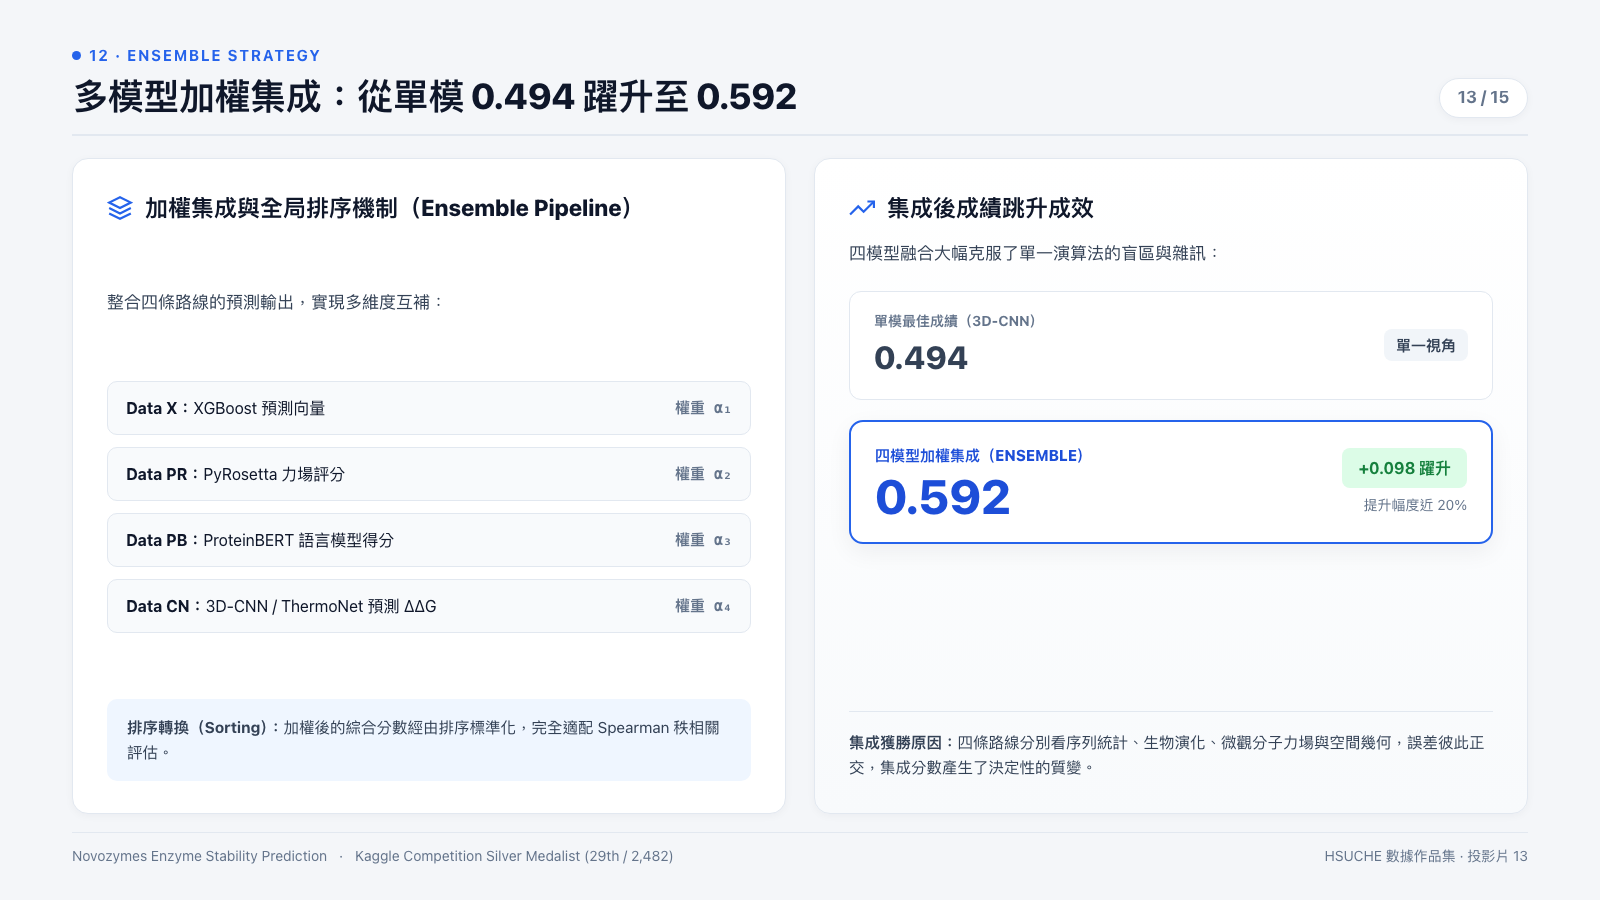
四條技術路線的預測輸出(Data X: XGBoost、Data PR: PyRosetta、Data PB: ProteinBERT、Data CN: 3D-CNN)分別賦予不同加權權重(α₁~α₄)進行多模型集成,再依 Spearman 指標特性進行全局排序輸出最終提交結果。各單模與集成分數整理如下:
| 模型路線 | 核心演算法 / 工具 | 特徵輸入與原理 | 評估得分 |
|---|---|---|---|
| 機器學習 | XGBoost | 序列長度、香農熵、atc、AAindex1(566 項理化指標)、aac 胺基酸頻率 | 0.168(單模) |
| 蛋白質語言模型 | ProteinBERT | 序列遷移學習,導入 Gene Ontology (GO) 微調 | 0.292(單模) |
| 生物物理模擬 | PyRosetta | 野生型 vs 突變型 PDB 空間對比,分子力場能量函數評分 | 0.471(單模) |
| 3D 深度學習 | 3D-CNN / ThermoNet | 突變周圍空間體素化,14 通道理化微環境 3D 卷積預測 ΔΔG | 0.494(單模) |
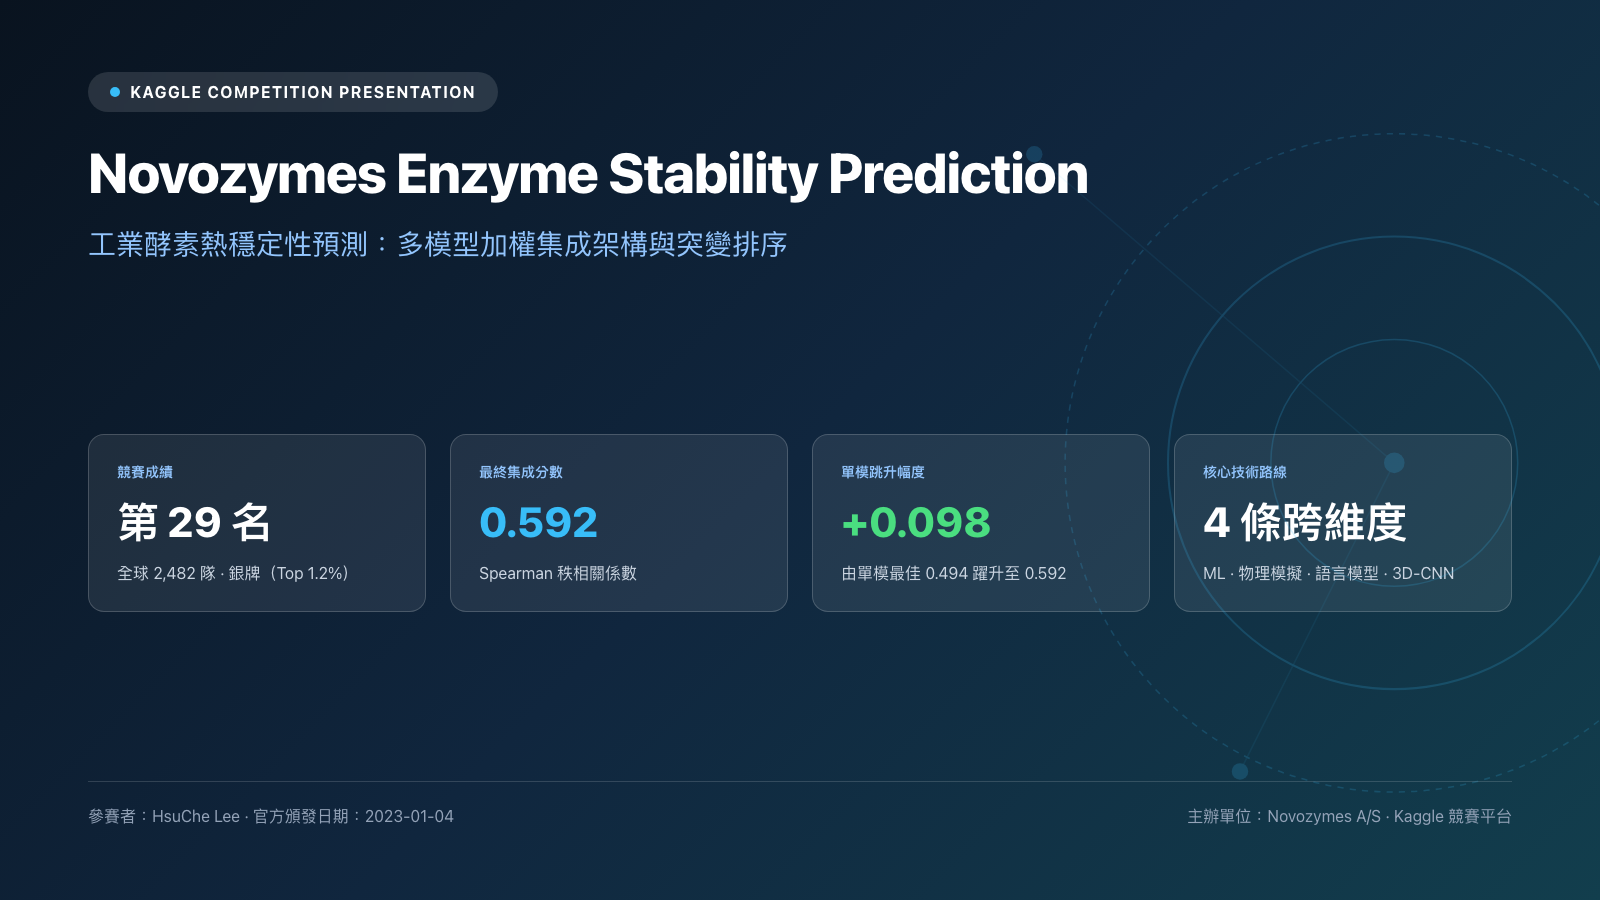
| 四模型集成 | Weighted Ensemble | Data X + Data PR + Data PB + Data CN 加權排序 | 0.592(最終提交集成) |
透過四模型集成,排行榜分數由單模最佳的 0.494 大幅提升至 0.592(提升幅度達 +0.098):四條路線分別觀察序列統計、演化語言、分子力場與空間幾何,誤差分布彼此互補,集成效果顯著優於任何單一模型。
04 · Results
成果與競賽成績
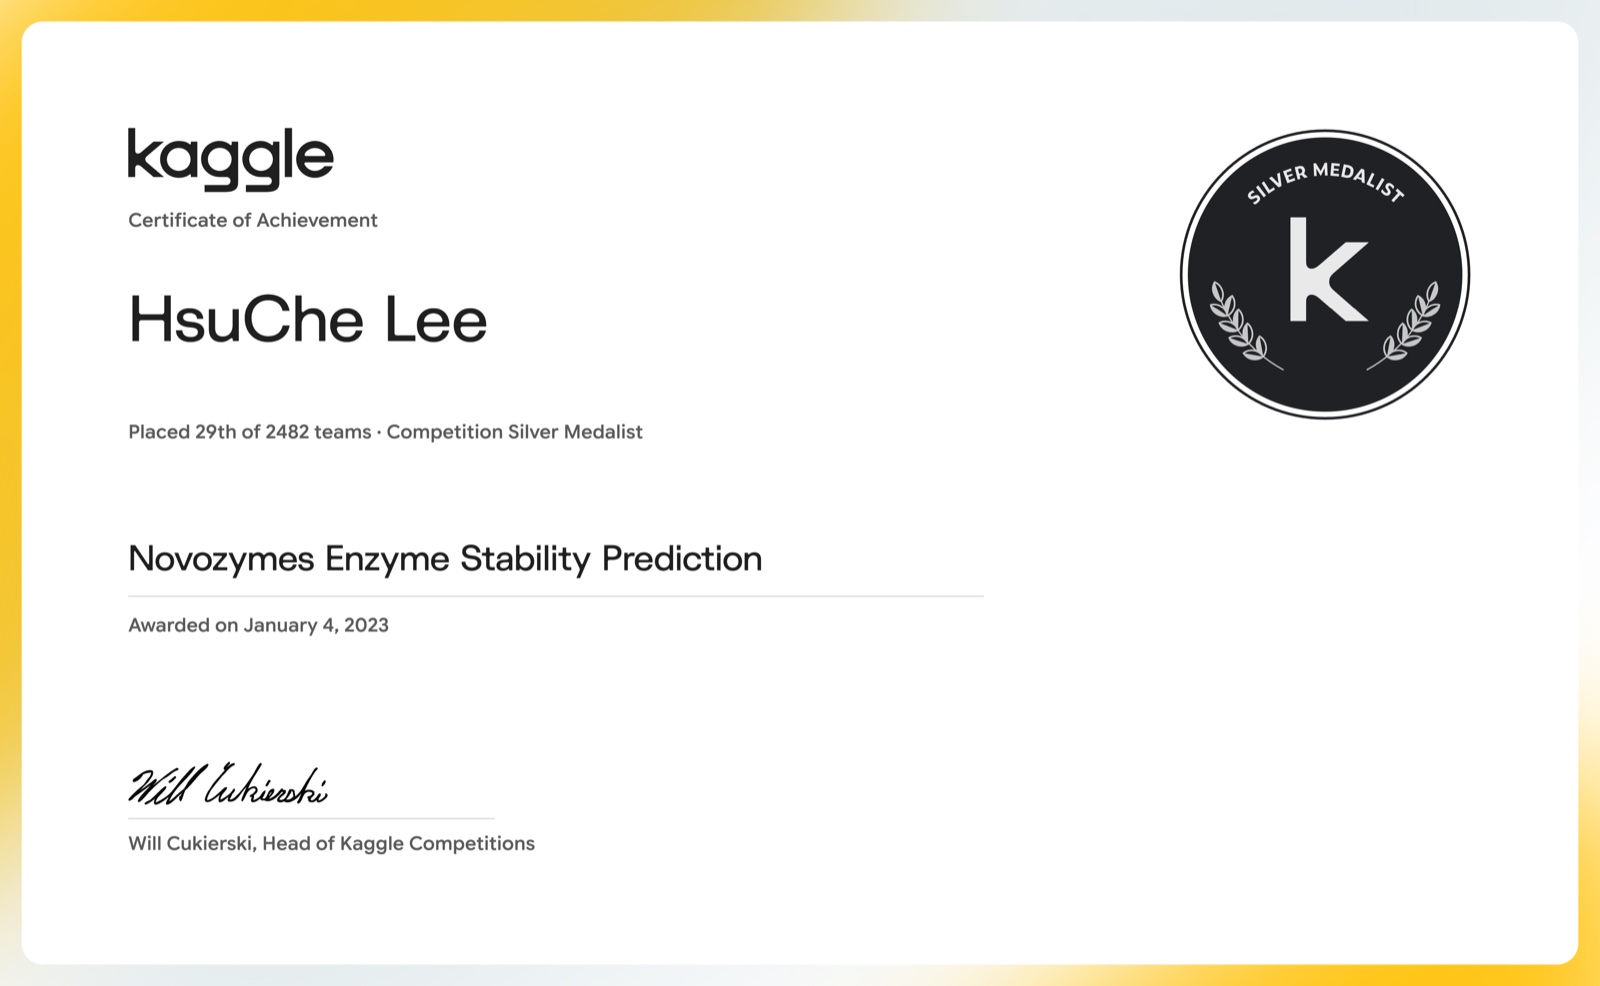
依據 Kaggle 官方結賽最終排行榜與官方結賽證書:
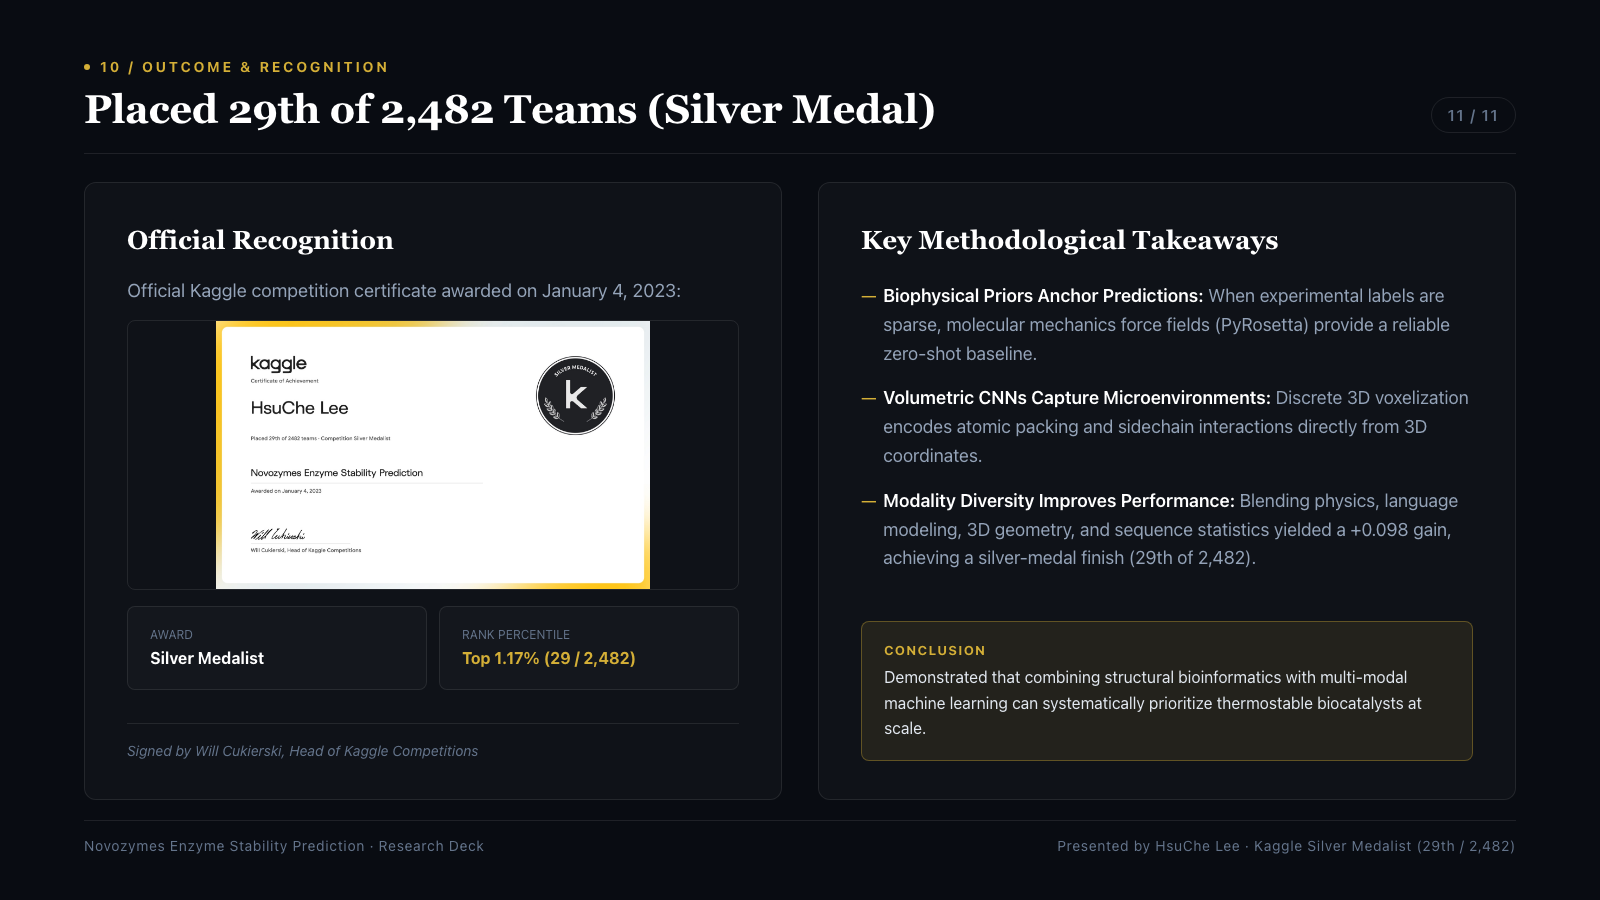
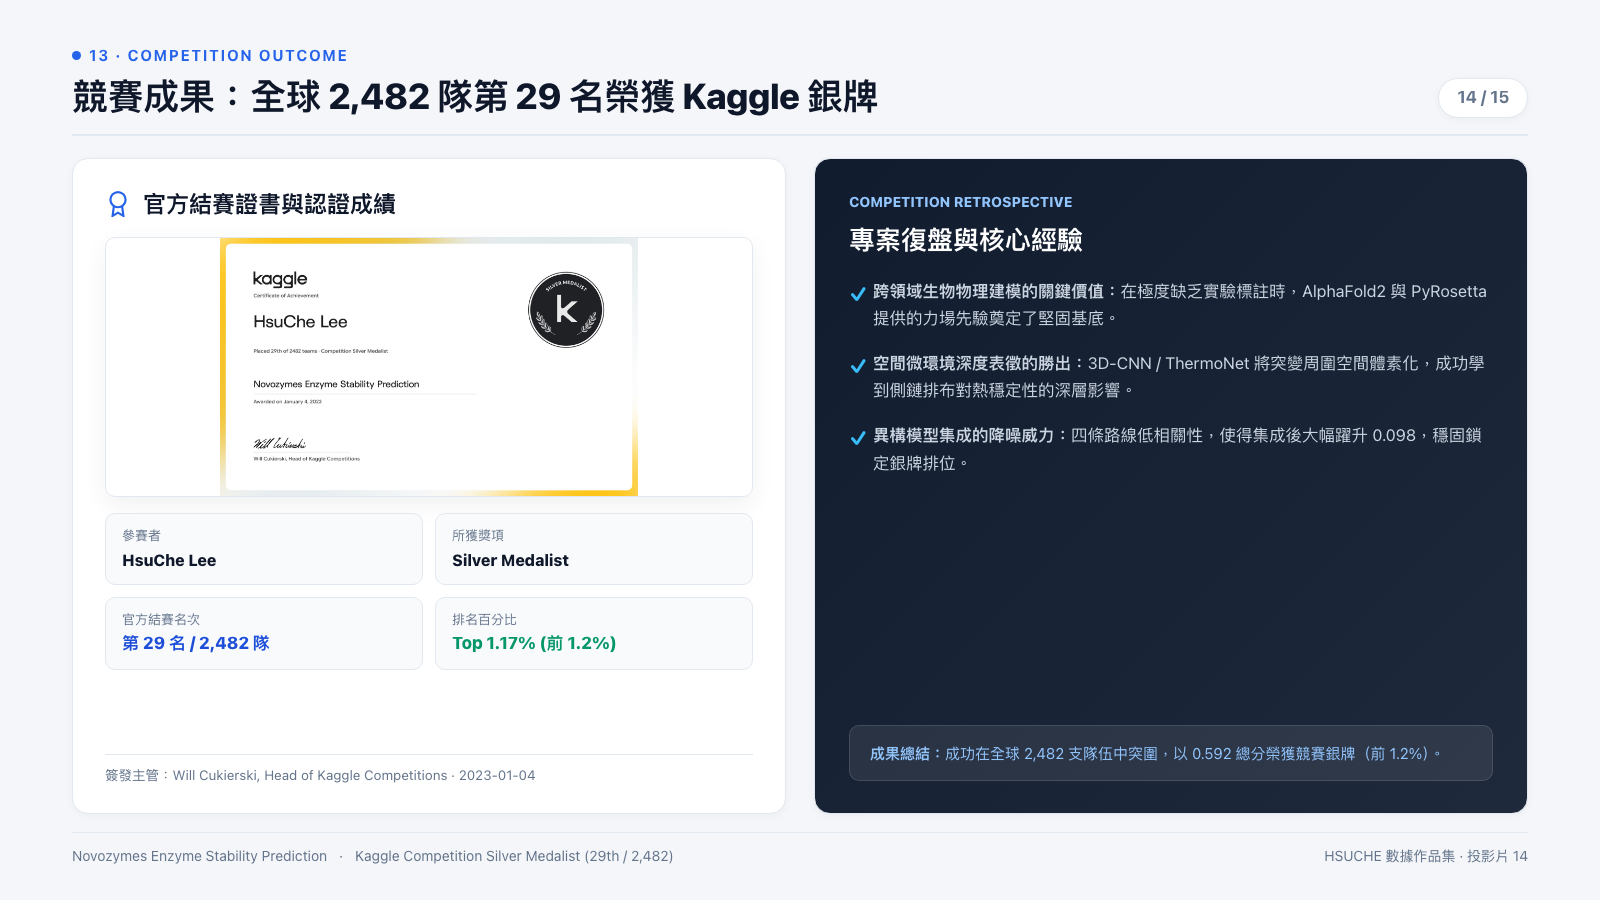
- 所獲獎項:Competition Silver Medalist(競賽銀牌)。
- 最終排名:在全球 2,482 支隊伍中名列第 29 名(證書載明:
Placed 29th of 2482 teams)。 - 名次百分比:位列全球全體參賽隊伍排名前 1.17%(約前 1.2%)。
- 頒發日期:2023 年 1 月 4 日(January 4, 2023),由 Kaggle 競賽負責人 Will Cukierski 簽發。
05 · References
參考資料與開源社群
本專案演算法與實作參考自 Kaggle 競賽公開社群分享之 Notebook 及蛋白質結構生物學前沿文獻:
Kaggle 公開 Notebook 引用
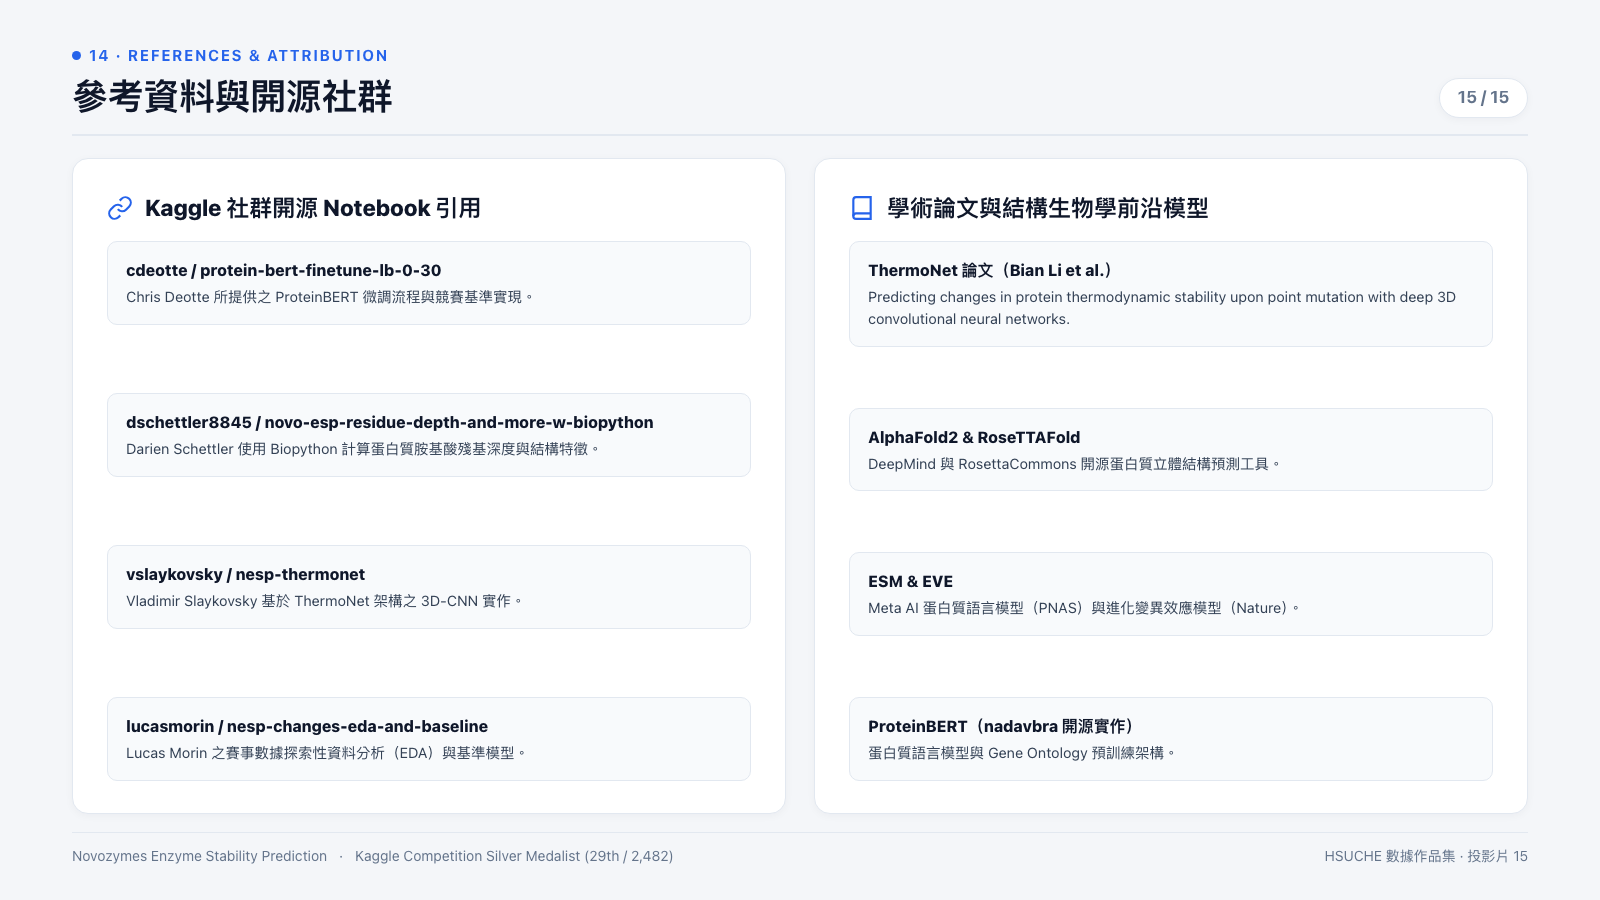
cdeotte/protein-bert-finetune-lb-0-30:Chris Deotte 所提供之 ProteinBERT 微調流程與基準實現。dschettler8845/novo-esp-residue-depth-and-more-w-biopython:Darien Schettler 使用 Biopython 計算蛋白質胺基酸殘基深度(Residue Depth)與結構特徵。vslaykovsky/nesp-thermonet:Vladimir Slaykovsky 基於 ThermoNet 架構之 3D-CNN 模型實作。lucasmorin/nesp-changes-eda-and-baseline:Lucas Morin 之賽事數據探索性資料分析(EDA)與基準評分。
學術論文與開源工具引用
- ThermoNet 論文:Bian Li, Yucheng T. Yang, John A. Capra, Mark B. Gerstein Predicting changes in protein thermodynamic stability upon point mutation with deep 3D convolutional neural networks.
- ESM:Meta AI 開源蛋白質語言模型(PNAS, 2021)。
- EVE:進化變異效應預測模型(Evolutionary model of variant effect, Nature, 2021)。
- AlphaFold2:DeepMind 開源蛋白質空間結構預測工具。
- RoseTTAFold:RosettaCommons 蛋白質立體結構預測工具。
- ProteinBERT:GitHub 使用者 nadavbra 的開源實作。