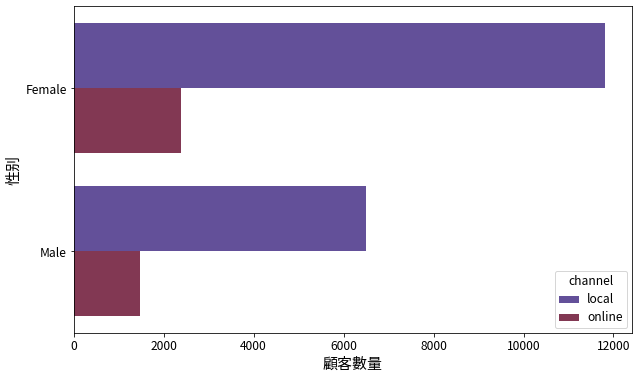
01 · Retail EDA
重點專案:Uniqlo 門市銷售數據分析
本專案使用公開的 Uniqlo 門市週銷售練習資料集(共 22,293 筆銷售紀錄,涵蓋 10 個城市、線上線下雙通路、顧客性別、年齡層、購買時間、9 種商品品類、顧客數、營收、訂單數、銷售數量與單位成本等 12 個欄位)。以商業營運導向出發,逐一拆解 6 個具體的業務問題:
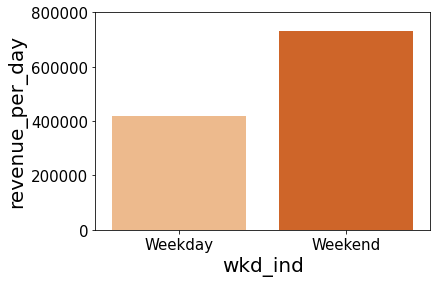
問題 1:週間與週末的銷售情況如何?
資料中工作日(Weekday)總銷售額為 2,093,947 元,週末(Weekend)總銷售額為 1,462,484 元。但工作日共有 5 天、週末僅有 2 天,換算單日平均營收後,週末單日營收(約 73.1 萬元)顯著高於工作日(約 41.9 萬元)。
問題 2:各城市在線上與線下通路的表現如何?
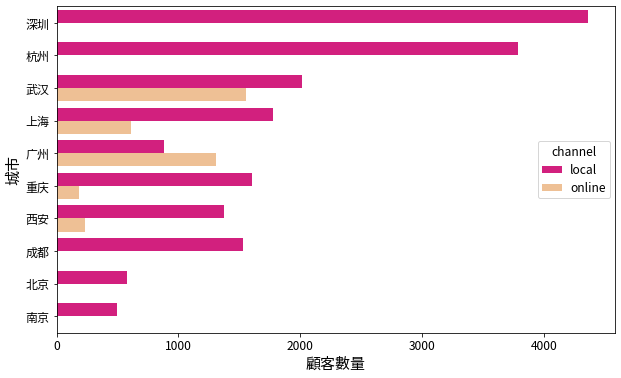
線下實體門市分佈於 10 個城市,其中以深圳(7,372 名顧客、73.3 萬元)與杭州(6,120 名顧客、58.9 萬元)為主力大店;線上通路則在 5 個城市具備獨立銷售紀錄,以武漢(2,864 名顧客、28.1 萬元)與廣州(2,089 名顧客、20.1 萬元)表現最為突出。
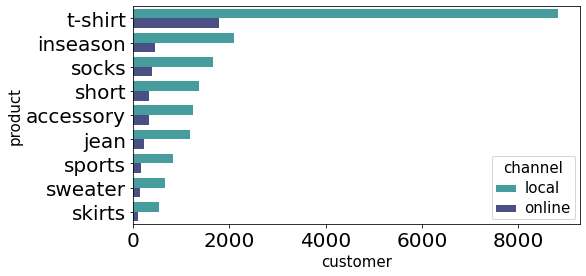
問題 3:哪些產品類別是營收主力?
在 9 個產品類別中,T恤(T-shirt)為全店最大營收來源,累計營收達 1,538,744 元,佔整體營收四成以上;其次為當季新品(590,664 元)與配件類(444,685 元)。
問題 4:哪些產品類別貢獻最高毛利?
以商品銷售金額扣除單位成本總合計算毛利額,T恤同樣貢獻全店最高毛利(635,919 元),其次為配件類(310,647 元)與當季新品(275,722 元)。配件類雖然總營收排名第三,但因成本結構相對輕盈,貢獻了第二高的毛利額。
問題 5:整體顧客樣貌與客群特徵是什麼?
顧客結構以女性為主力,在有性別標記的紀錄中女性佔 64%(14,208 筆),男性佔 36%(7,967 筆)。年齡分佈高度集中在青年與青壯年族群,其中 20–24 歲、25–29 歲與 30–34 歲合計佔整體顧客大宗。
問題 6:產品成本與銷售額 / 毛利率的關係?
計算單位成本(unit_cost)與毛利率(margin)之相關係數僅為 0.10275,呈現低度相關,顯示產品定價與毛利結構並非單純依成本比例加成。在細部觀察中,毛衣與裙子品類出現部分負毛利銷售紀錄,推論可能來自換季清倉或促銷折價折扣。
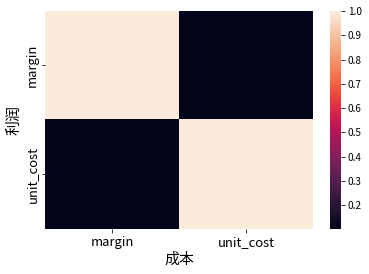
本子專案原始程式碼可至 GitHub 查看:uniqlo_sales_data(GitHub)。
02 · Selected Cases
精選練習:五組機器學習與數據專案
1. Kaggle 鐵達尼號生還預測(Titanic Survival)
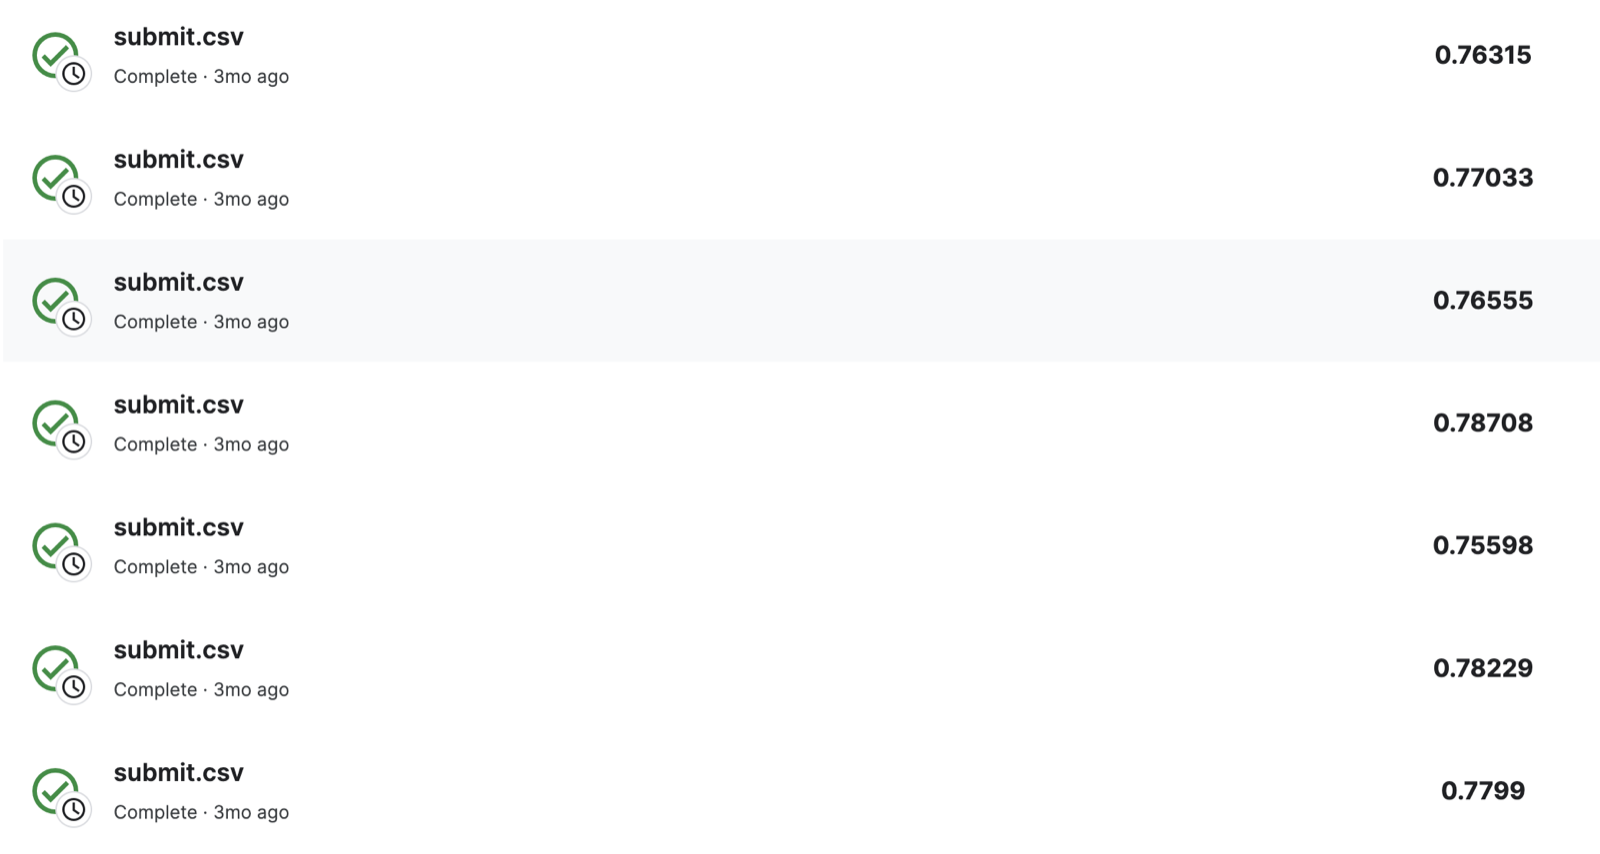
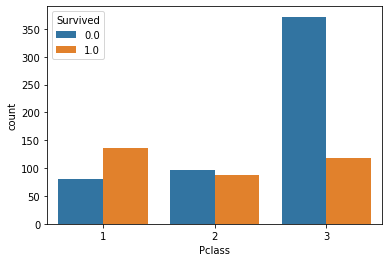
經典二元分類問題。主要針對原始欄位進行特徵工程:從 Name 欄位中以正規表達式提取稱謂(Mr, Mrs, Miss, Master 等)以補足身分特徵;結合同行親屬欄位(SibSp, Parch)計算家庭規模(FamilySize);對票價(Fare)填補缺失值並進行離散分箱。模型階段比較 RandomForest、XGBoost(配合 GridSearchCV 搜尋最佳超參數)與 Support Vector Classifier (SVC)。最終將預測結果上傳至 Kaggle 平台,獲得官方排行榜成績 0.78229。
本子專案原始程式碼可至 GitHub 查看:titanic_survival_prediction(GitHub)。
2. Kaggle 腦中風風險預測(Stroke Prediction)
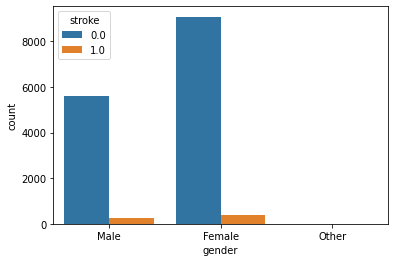
探討性別、年齡、高血壓、心臟病、BMI、平均血糖與吸菸習慣等 11 個生理與生活型態特徵對腦中風機率之影響。競賽資料中中風陽性樣本佔比極低(高度類別不平衡),因此在邏輯迴歸模型中導入 class_weight='balanced' 以加權少數類樣本損失,並進一步訓練 XGBoost 模型評估特徵重要性,最後產生測試集預測提交檔案。
本子專案原始程式碼可至 GitHub 查看:Stroke_Prediction_Kaggle_competitions(GitHub)。
3. 華盛頓州金郡房價預測(King County House Sales)
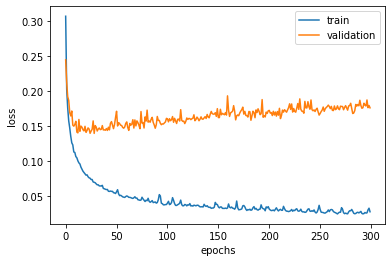
使用美國華盛頓州 King County 共 21,613 筆房屋銷售資料與 21 個特徵(含房間數、衛浴數、坪數、樓層、屋況評級、經緯度等)。首先建立多元線性迴歸作為基準模型,接著訓練隨機森林迴歸模型;此外使用 Keras Sequential 建構了 4 種不同深度的類神經網絡架構,對比不同隱藏層層數、Dropout 比例與 L2 正則化參數在訓練與驗證損失上的收斂狀況。
本子專案原始程式碼可至 GitHub 查看:kc_house_price_predicting(GitHub)。
4. 寶可夢歷史對戰勝負預測(Pokemon Combat)
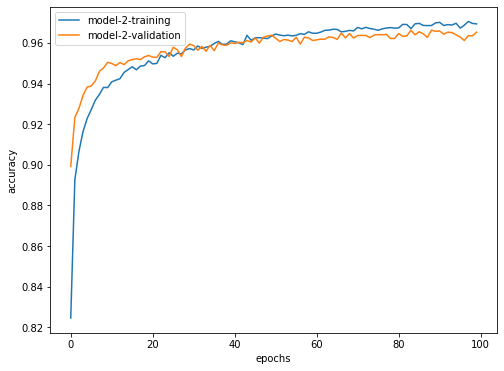
結合 50,000 筆歷史對戰紀錄與 800 隻寶可夢數值屬性。資料處理階段針對雙屬性(Type 1, Type 2)進行缺失值補齊與 One-Hot Encoding,轉換為數值向量;接著使用 TensorFlow/Keras 建立多層密集類神經網絡(Dense layers、ReLU 活化函數、Sigmoid 輸出層),以二元交叉熵作為損失函數訓練對戰勝負模型;並實作輸入任意兩隻寶可夢數值即可計算各自獲勝機率的自定義測試函式。
本子專案原始程式碼可至 GitHub 查看:pokemon_combat(GitHub)。
5. 2022 世界環境績效指標評比(EPI 2022 Result)
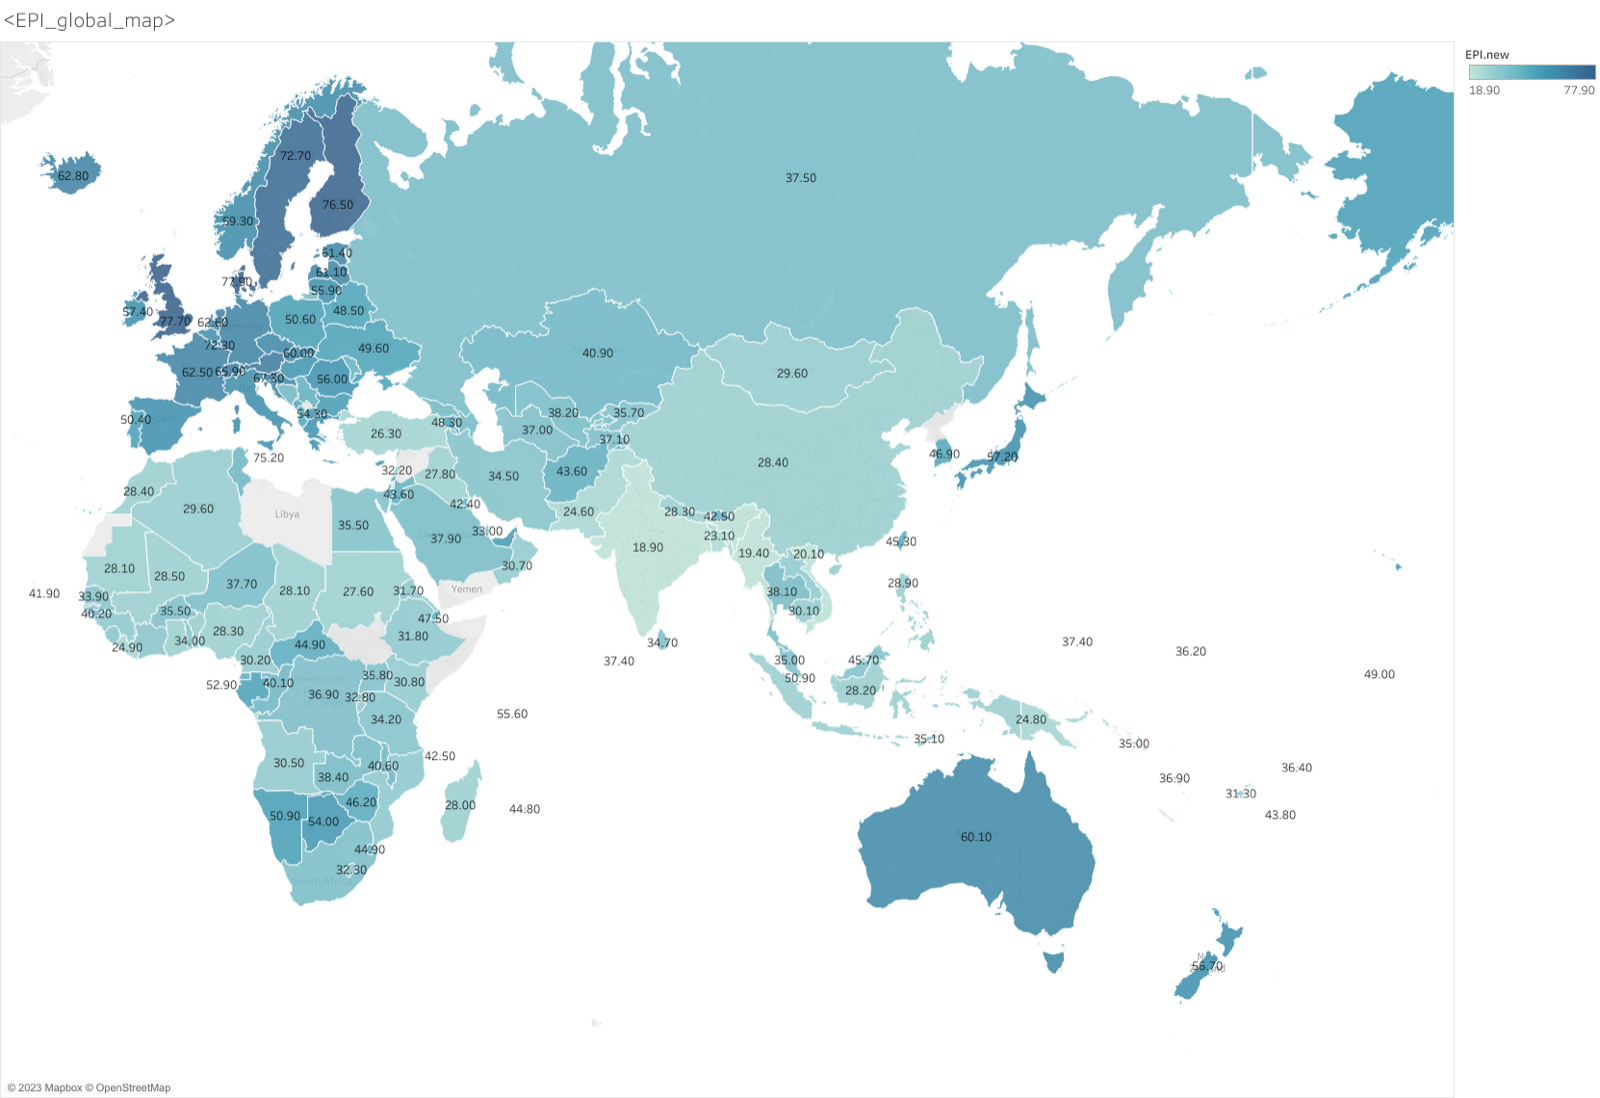
解析耶魯大學與哥倫比亞大學發布之 2022 年世界環境績效指數(Environmental Performance Index),資料涵蓋全球 180 個國家與 159 個環境健康與生態永續指標。分析全球不同地理區域的環境得分落差;針對台灣全球排名第 74 名進行弱項指標下鑽,指出台灣在二氧化硫(SO2 得分 10.3)、一氧化碳(CO 得分 30.3)以及濕地保護(Wetland loss)與農藥管控方面落後於全球前 75 分位,並從產業結構與政策面提出後續深入追蹤之維度假設。

本子專案原始筆記可至 GitHub 查看:EPI_2022_result(GitHub)。
03 · Repository
開源專案庫連結
本頁整理的練習題目、完整 Notebook 檔案與資料處理程式碼,皆存放於作者 GitHub 開源倉庫中: