01 · Background
專案背景與演講實況
假日想出門走走,或者抵達某個景點後想知道「下一站能去哪」,往往面臨資訊過載的痛點。網路上的推薦部落格多半充斥業配或主觀喜好,而 Google Maps 上的評論動輒數百上千則,逐一瀏覽費時費力,更難以快速歸納出該景點的真實口碑與核心特色。
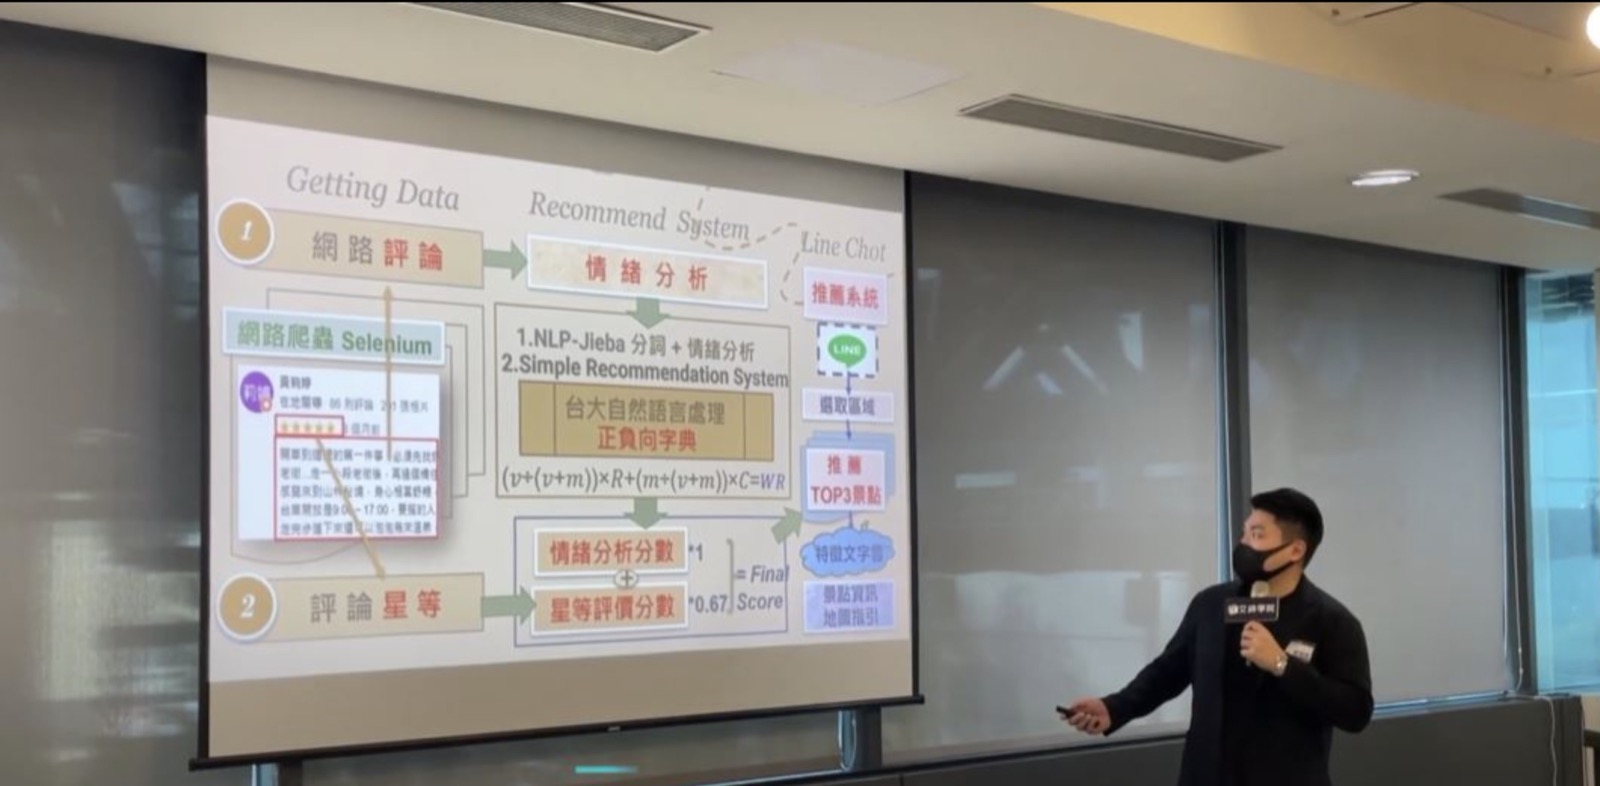
為了解決這個問題,我設計並實作了「雙北旅遊景點推薦系統」:整合自動化評論爬蟲、Jieba 中文斷詞、正負向情緒字典與加權評分演算法,並透過 LINE 官方帳號提供互動式階層查詢與景點關鍵字文字雲。本專案曾於公開技術分享場合進行專題演講,現場拆解從資料工程、演算法設計到雲端服務部署的完整開發鏈路。
02 · Architecture
全鏈路系統架構
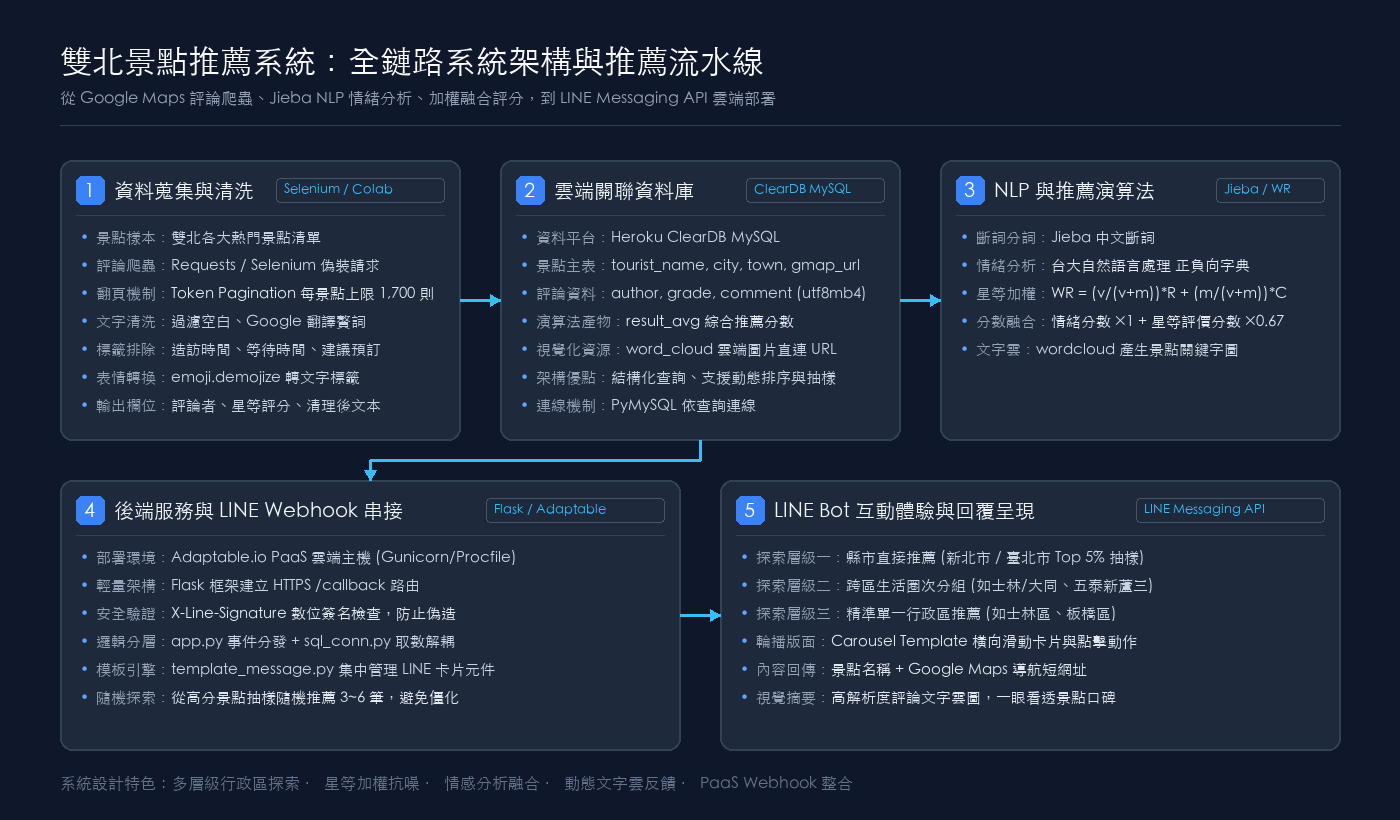
整體系統分為五大核心模組,涵蓋離線資料處理流水線與即時線上回應架構:
以雙北景點資料庫為基礎,透過 Google Maps 評論爬蟲定期抓取各景點最新評論,進行標籤過濾與 Emoji 轉文字預處理。
採用雲端 MySQL(ClearDB)儲存景點主檔、評論文本、星等評分、計算後的綜合推薦分數與文字雲圖片連結。
使用 Jieba 進行中文斷詞,結合自建情緒字典計算情緒得分,並導入 IMDb 加權評分公式抗噪,融合成最終推薦權重。
以 Python Flask 開發 Webhook 伺服器,驗證 LINE 數位簽名,並部署於 PaaS 雲端主機(Adaptable.io)。
提供縣市、區域次群組、行政區三層選單,回傳 Carousel 輪播卡片,附帶 Google Maps 導航連結與動態評論文字雲。
03 · Data & NLP
資料蒐集與自然語言處理
1. Google Maps 評論爬蟲設計
資料源自雙北觀光景點清單。為了掌握景點近期的真實旅客口碑,爬蟲鎖定排序為「最新」的評論,透過 Token 翻頁機制(Next Page Token)批次抓取,每個景點上限設定為 1,700 則評論。在資料採集過程中,設計了隨機 User-Agent 輪替與 0.5~2 秒隨機延遲,降低被目標服務阻擋的風險。
2. 文字清洗與表情符號轉換
Google Maps 評論常包含大量系統介面標籤與非文字雜訊,若直接進行斷詞會嚴重干擾統計:
- 翻譯標籤分離:過濾
(由 Google 提供翻譯)與(原始評論),確保優先保留使用者原始輸入的文字內容。 - 介面元資料排除:清理「上次造訪時間」、「等待時間」、「建議預訂」、「⋯⋯更多」等系統結構化標記。
- 表情符號轉換:導入
emoji.demojize,將常見的表情符號轉換為可供 NLP 處理的文字標籤(例如:sparkles:或:thumbs_up:),保留旅客的情緒色彩。
3. Jieba 斷詞與特色文字雲
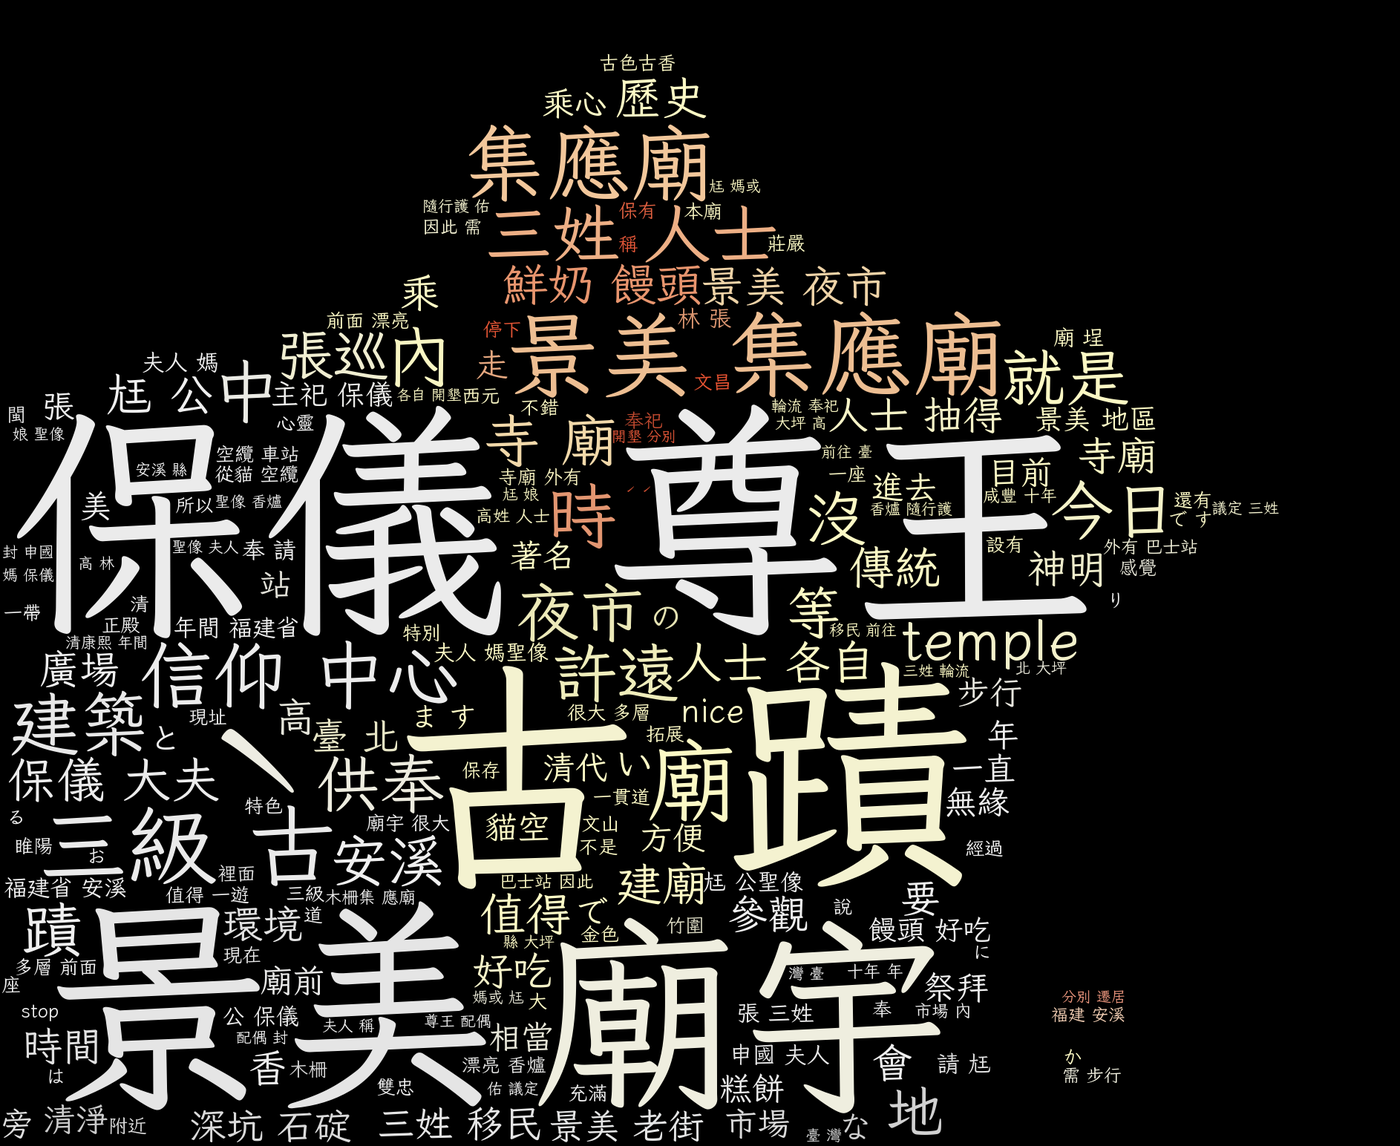
評論清理完成後,以 jieba 進行中文斷詞,再用 wordcloud 套件為每個景點產生關鍵字文字雲,把評論裡反覆出現的特色(建築、小吃、歷史典故等)濃縮成一張圖。文字雲上傳後以圖片連結存進資料庫,LINE Bot 回覆時直接帶出。
04 · Algorithm
推薦演算法與評分機制
如果單純依照「Google Maps 平均星等」進行排序,常會產生顯著偏差:一處只有 2 則 5 星評論的新開景點,排名會直接壓過累積 1,500 則評論且平均 4.7 星的成熟經典景點。這在推薦系統中屬於典型的「小樣本極端值偏誤」。
1. 星等加權評分(Weighted Rating, WR)
為了解決評分樣本不均的問題,星等部分採用 IMDb 式的加權評分公式:
- v:該景點的評論數。
- m:進入排名所需的最低評論數門檻。
- R:該景點的平均星等。
- C:全體景點的平均星等。
評論數 v 少的時候,分數會被拉向全體平均 C;評論數遠超過門檻 m 之後,景點自己的平均星等 R 才會主導分數,少數極端評價就不容易把排名帶偏。
2. 情緒分析與綜合得分
星等之外,評論文字的語氣也反映遊客滿意度。情緒分析使用台大自然語言處理的正負向字典,對斷詞後的評論計分;最後把情緒分析分數與星等評價分數加權相加,得到排序用的綜合分數(資料庫欄位 result_avg):
這樣排序同時看「大家給幾顆星」和「評論實際怎麼說」,LINE Bot 查詢時直接依這個分數排序。
05 · LINE Bot
LINE 機器人互動與成果展示
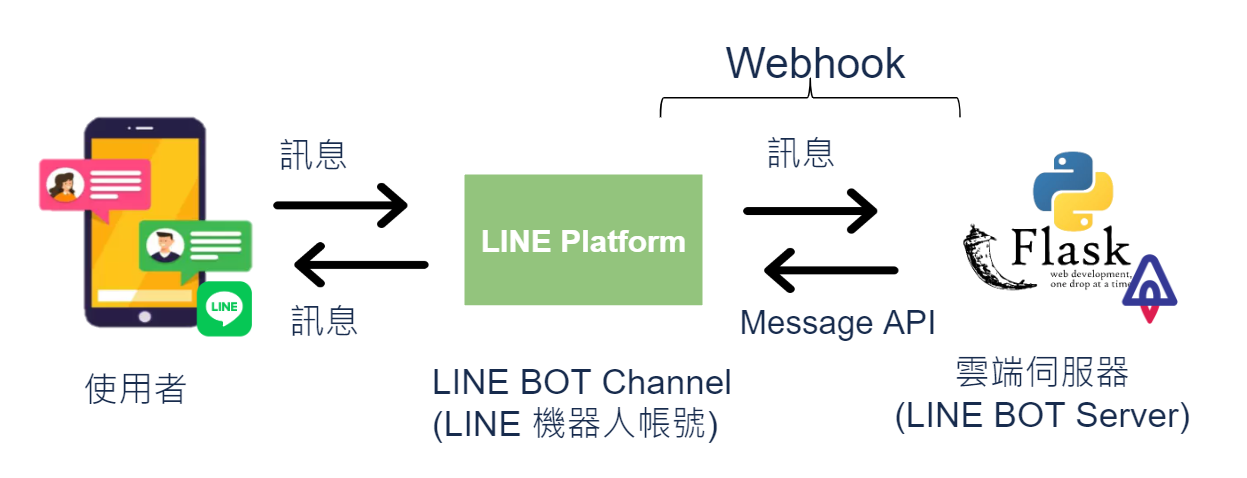
1. Webhook 雙向通訊架構
使用者在 LINE App 傳送文字指令時,LINE 平台會發出 HTTPS POST 請求至後端伺服器的 /callback 路由。Flask 後端首先藉由 X-Line-Signature 檢查請求的數位簽名是否合法,再由 WebhookHandler 將訊息派發給對應的處理函數,從 MySQL 查詢資料後透過 LINE Messaging API 封裝為範本訊息回傳。
2. 三階層式探索選單與防僵化機制
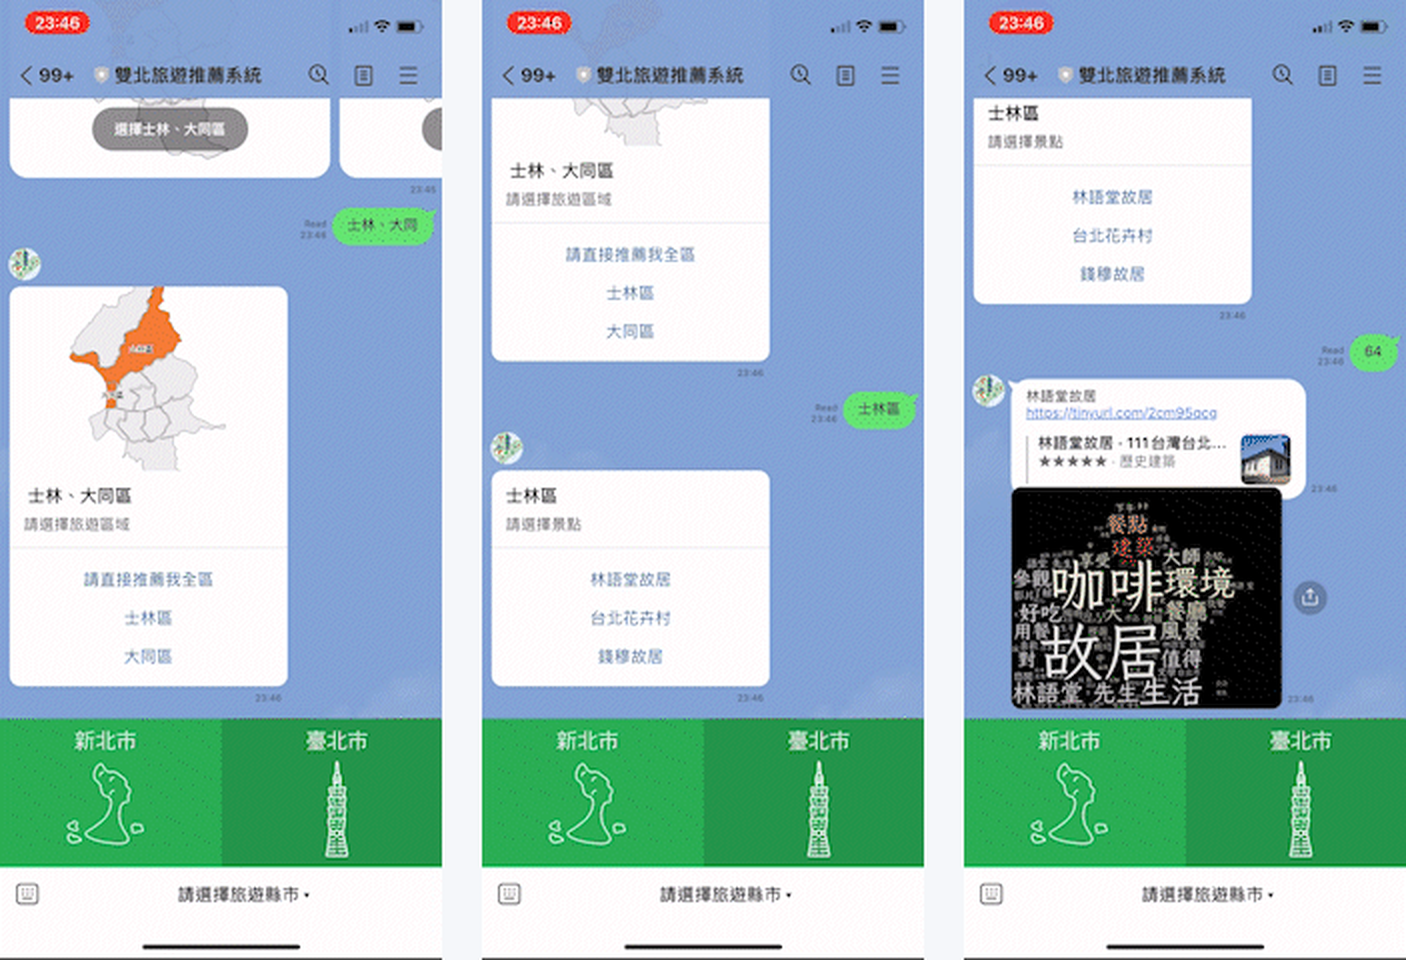
雙北行政區數量龐大,若一次列出幾十個行政區會大幅增加使用者認知負擔。系統設計了三種不同粒度的探索路徑:
- 直選縣市推薦:使用者直接點擊「臺北市」或「新北市」,系統自該縣市排序前 5% 的最高分景點中隨機抽取 6 處,呈現雙北頂級推薦。
- 跨區生活圈次分組:將地理相鄰的行政區合併為群組(例如「士林、大同區」或「五股、泰山、新莊、蘆洲、三重區」),方便以區域生活圈為導向的探索。
- 精準行政區推薦:下鑽至特定行政區(如士林區),系統由該區綜合得分排名前 50% 的景點中篩選 3 筆呈現。
為了避免使用者每次點選同一個區域都看到一模一樣的景點,後端在取得 Top 景點集合後會進行隨機抽樣(Random Shuffle),既維持了高推薦品質,又具備探索新景點的驚喜感。
3. 互動展示與圖文回傳成果
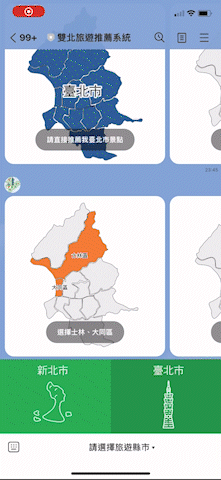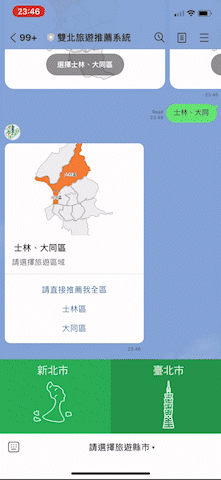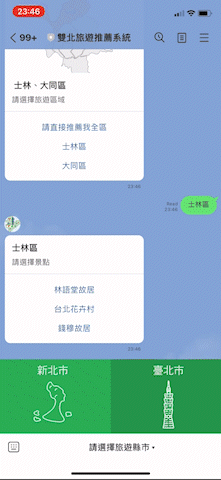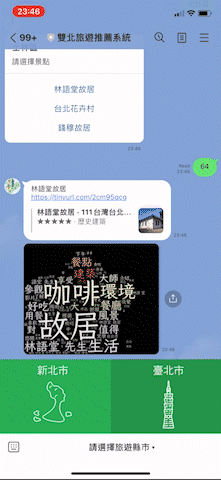
使用者選定具體景點後,聊天機器人會立即回傳包含景點名稱、Google Maps 導航短網址,以及一目了然的評論特色文字雲圖片。旅客無須逐篇翻閱幾百則評論,即可在手機畫面上秒懂該景點好玩在哪、必看重點與注意事項。
06 · Retrospective
系統限制與後續改進方向
- 免費 PaaS 平台的冷啟動:免費雲端主機閒置一段時間後會休眠,使用者在休眠期間傳訊息,第一次回應會明顯變慢。後續可改用常駐主機,或定時喚醒服務。
- 離線批次爬蟲的時效維護:目前的評分與文字雲為單次批次運算後寫入資料庫,尚缺乏自動化的定期增量排程機制。未來可結合每週排程爬取最新評價,使文字雲與情緒評分隨季節動態更新。
- 多維度推薦特徵擴充:目前推薦主要依賴地理區域、星等與情緒分數。若能進一步結合停留時間標籤、室內/戶外屬性、即時天氣 API 與使用者個人化偏好標籤,推薦精準度將能更進一步提升。
本專案完整原始碼與 Colab 爬蟲腳本已整理公開於 GitHub:jelink27/Tourist-attraction-recommender-system。